Threads virtuels et sémaphores DB : contrôler l’admission avant le pool de connexions
Sur cette page
Utiliser des threads virtuels n’impose pas d’ajouter un sémaphore devant la base de données. Le pool de connexions limite déjà le nombre de connexions. Un sémaphore supplémentaire est utile pour rejeter plus tôt le travail destiné à la base, borner le nombre d’opérations admises ou attribuer des budgets de concurrence à certaines charges de travail. Le guide d’Oracle sur les threads virtuels explique lui aussi qu’un pool de connexions à une base agit déjà comme un sémaphore. Guide d’Oracle sur les threads virtuels
Cet article prolonge la comparaison des threads virtuels entre JDK 21–25 en abordant les connexions aux bases de données. Il précise la frontière du travail en base au sein du contrôle d’admission plus large présenté dans l’architecture à 10k RPS. Le périmètre couvre Java 21 ou ultérieur, avec une transaction JDBC synchrone utilisant une connexion. Le sémaphore doit être partagé à l’échelle d’une instance de l’application ; il ne faut pas en créer un pour chaque requête.
Que limiter lorsqu’un pool de connexions existe déjà ?
Les threads virtuels permettent de conserver de nombreuses tâches en attente avec un surcoût relativement faible lié aux threads. À eux seuls, ils n’augmentent pas la capacité de traitement des requêtes de la base et ne réduisent pas la contention sur les verrous. Les requêtes attendant une connexion dans un pool saturé occupent toujours de la mémoire et conservent leur état.
| Situation | Premier contrôle à appliquer |
|---|---|
| Les limites de connexion et d’attente du pool suffisent | Conserver la configuration du pool de connexions |
| Vous voulez rejeter les requêtes en surcharge avant leur entrée dans le pool | Ajouter un contrôle d’admission |
| Un traitement par lots ou des requêtes coûteuses monopolisent les connexions | Fixer des budgets par charge de travail ; séparer les pools si nécessaire |
| Du SQL lent ou des verrous retiennent les connexions trop longtemps | Examiner d’abord les requêtes, les index, les transactions et les limites de la base |
Dans HikariCP, maximumPoolSize limite le nombre de connexions du pool. Si aucune n’est disponible, getConnection() attend jusqu’à connectionTimeout, puis lève une exception. Sa valeur minimale est de 250ms. Limiter l’attente du sémaphore à 20ms ne limite pas pour autant celle du pool à 20ms. Configuration de HikariCP
Borner l’exécution et l’admission totale
L’exemple utilise deux sémaphores.
- B permis d’exécution : limitent les opérations en cours, de l’acquisition de la connexion jusqu’à la fin de la transaction et du nettoyage de la connexion.
- B+Q permis d’admission : limitent toutes les opérations à l’intérieur de cette barrière, y compris celles qui attendent un permis d’exécution. Rejeter immédiatement lorsqu’aucun permis d’admission n’est disponible.
Lorsque les B permis d’exécution sont tous utilisés, il peut rester au plus Q opérations admises supplémentaires. Cependant, des tâches peuvent aussi être planifiées avant d’acquérir un permis d’exécution : cela ne signifie donc pas que le nombre de tâches en attente est toujours exactement borné par Q à chaque instant. Un sémaphore unique qui limite seulement le temps d’attente ne borne pas le nombre de tâches admises en attente.
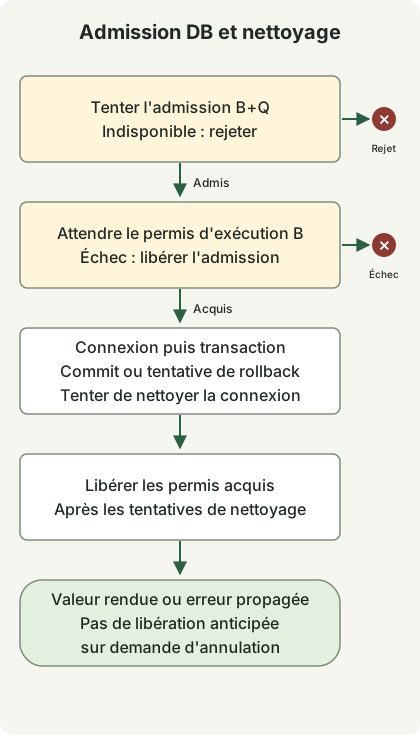
Le bloc des ressources de la base résume les chemins d’exception internes. Si l’acquisition de la connexion échoue, ignorer le travail et passer à la libération des permis. Si la préparation de la transaction échoue, tenter de nettoyer la connexion acquise. Si le travail ou le commit échoue, tenter un rollback.
Si l’admission échoue, aucun permis n’est à libérer. Si l’acquisition du permis d’exécution échoue ou si le thread en attente est interrompu, libérer uniquement le permis d’admission. Une fois les deux permis acquis, les libérer après que l’acquisition de la connexion, le traitement transactionnel et le nettoyage se sont terminés, normalement ou par exception. Ne pas libérer les permis depuis un autre thread au seul motif que l’appelant a dépassé son délai. Si le travail réel en base continue, cela peut dépasser la limite d’exécution configurée.
Comment choisir B, Q et la taille du pool ?
B compte des opérations simultanées en base, pas des requêtes par seconde. Il inclut l’attente d’acquisition d’une connexion, le commit et le nettoyage : la concurrence SQL effective peut donc être inférieure à B. Pour le choisir, mesurer la saturation de la base, la durée de détention des connexions et les budgets des autres charges. Q est le nombre d’opérations supplémentaires à admettre en cas de surcharge ; le choisir en tenant compte du budget d’attente et de la mémoire.
Par exemple, avec un pool P=24 et une barrière B=16, au plus 16 opérations peuvent être en cours à travers cette barrière. Les 8 connexions restantes ne sont pas réservées à d’autres traitements. Des appelants extérieurs à la barrière partageant le pool pourraient occuper toutes les connexions. Même si des pools distincts sont utilisés pour l’isolation, additionner leurs budgets de connexion au niveau de la base.
Pour établir les limites de connexion, vérifier peak simultaneous instances × pool size per instance + batch, operations and other client connections ≤ DB connection budget. Le pic d’instances inclut l’autoscaling et le chevauchement des anciennes et nouvelles instances lors d’un déploiement progressif. instance count × B borne uniquement le travail passant par cette barrière. Ces nombres illustrent le calcul ; ce ne sont ni des réglages recommandés ni des mesures de performance.
Un exemple JDBC exécutable
La barrière de l’exemple gère elle-même sa transaction et sa connexion. La fonction de rappel doit s’exécuter de manière synchrone et ne renvoyer qu’une valeur entièrement matérialisée. Ne pas effectuer de commit, de rollback ni modifier l’auto-commit dans cette fonction. Renvoyer une Connection, un ResultSet ou un flux de requête évalué à la demande, ou démarrer un travail asynchrone distinct en base dans la fonction de rappel, échappe à la protection de cette frontière.
DbBulkhead.java
import java.sql.Connection;
import java.sql.SQLException;
import java.time.Duration;
import java.util.Objects;
import java.util.concurrent.RejectedExecutionException;
import java.util.concurrent.Semaphore;
import java.util.concurrent.TimeUnit;
import javax.sql.DataSource;

public final class DbBulkhead {
    @FunctionalInterface
    public interface SqlWork<T> {
        T run(Connection connection) throws SQLException;
    }

    private final DataSource source;
    private final Semaphore slots;
    private final Semaphore running;

    public DbBulkhead(DataSource source, int concurrent, int extraSlots) {
        this.source = Objects.requireNonNull(source);
        if (concurrent < 1 || extraSlots < 0) {
            throw new IllegalArgumentException("invalid capacity");
        }
        slots = new Semaphore(Math.addExact(concurrent, extraSlots));
        running = new Semaphore(concurrent, true);
    }

    public <T> T transaction(Duration queueWait, SqlWork<T> work)
            throws SQLException, InterruptedException {
        Objects.requireNonNull(work);
        long nanos = queueWait.toNanos();
        if (nanos < 0) throw new IllegalArgumentException("negative wait");
        if (!slots.tryAcquire()) {
            throw new RejectedExecutionException("db admission full");
        }
        boolean acquired = false;
        try {
            acquired = running.tryAcquire(nanos, TimeUnit.NANOSECONDS);
            if (!acquired) {
                throw new RejectedExecutionException("db admission timed out");
            }
            try (Connection connection = source.getConnection()) {
                connection.setAutoCommit(false);
                try {
                    T value = work.run(connection);
                    connection.commit();
                    return value;
                } catch (SQLException | RuntimeException | Error failure) {
                    try {
                        connection.rollback();
                    } catch (SQLException rollbackFailure) {
                        failure.addSuppressed(rollbackFailure);
                    }
                    throw failure;
                }
            }
        } finally {
            if (acquired) running.release();
            slots.release();
        }
    }

    int available() { return running.availablePermits(); }
    int availableSlots() { return slots.availablePermits(); }
}
Le code ne libère running que si le permis a été acquis : un échec d’attente ou une interruption ne peut donc pas gonfler le nombre de permis. Les exceptions SQL, les exceptions d’exécution et les erreurs déclenchent une tentative de rollback ; si celle-ci échoue, cet échec est rattaché à l’exception d’origine en tant qu’exception secondaire. L’appelant ne reçoit la valeur de retour qu’après la fin du commit et de close() sur la connexion. Si le commit échoue, ou si le nettoyage de la connexion échoue après le commit, une écriture peut avoir pris effet alors même que l’appelant reçoit une exception. Ne pas relancer systématiquement les écritures.
Même un sémaphore équitable ne garantit pas l’ordre de bout en bout pour chaque requête. L’exemple utilise une acquisition avec délai sur un sémaphore d’exécution équitable, mais une acquisition immédiate pour l’admission. Sans délai, tryAcquire() ne respecte pas le réglage d’équité. Les méthodes available() servent à observer l’expérience ; lire leurs valeurs puis décider séparément de l’admission crée une condition de concurrence (race condition). API Semaphore
La démonstration configure une taille de pool de 2, B=1 et Q=0. Elle vérifie qu’une seconde opération est rejetée pendant que la première transaction détient son permis. Retenir brièvement la transaction à l’aide d’un mécanisme de synchronisation de type latch coordonne la reproduction ; ce n’est pas un modèle recommandé pour le traitement dans un service.
Demo.java
import com.zaxxer.hikari.HikariConfig;
import com.zaxxer.hikari.HikariDataSource;
import java.sql.SQLException;
import java.time.Duration;
import java.util.concurrent.CountDownLatch;
import java.util.concurrent.ExecutionException;
import java.util.concurrent.Executors;
import java.util.concurrent.RejectedExecutionException;
import java.util.concurrent.TimeUnit;

public class Demo {
    static HikariDataSource pool() {
        HikariConfig config = new HikariConfig();
        config.setJdbcUrl(System.getenv("DB_URL"));
        config.setUsername(System.getenv("DB_USER"));
        config.setPassword(System.getenv("DB_PASSWORD"));
        config.setMaximumPoolSize(2);
        config.setMinimumIdle(0);
        config.setConnectionTimeout(500);
        config.setValidationTimeout(250);
        return new HikariDataSource(config);
    }

    public static void main(String[] args) throws Exception {
        try (var pool = pool(); var tasks = Executors.newVirtualThreadPerTaskExecutor()) {
            var gate = new DbBulkhead(pool, 1, 0);
            var entered = new CountDownLatch(1);
            var release = new CountDownLatch(1);
            var first = tasks.submit(() -> gate.transaction(Duration.ZERO, connection -> {
                if (!Thread.currentThread().isVirtual()) throw new AssertionError();
                try (var statement = connection.createStatement()) {
                    statement.setQueryTimeout(2);
                    try (var rows = statement.executeQuery("SELECT 42")) {
                        rows.next();
                        int value = rows.getInt(1);
                        entered.countDown();
                        try {
                            if (!release.await(5, TimeUnit.SECONDS)) {
                                throw new SQLException("demo coordination timed out");
                            }
                        } catch (InterruptedException interrupted) {
                            Thread.currentThread().interrupt();
                            throw new SQLException("demo interrupted", interrupted);
                        }
                        return value;
                    }
                }
            }));
            try {
                if (!entered.await(5, TimeUnit.SECONDS)) throw new AssertionError("not entered");
                var second = tasks.submit(() -> gate.transaction(Duration.ZERO, c -> 0));
                try {
                    second.get(5, TimeUnit.SECONDS);
                    throw new AssertionError("must reject");
                } catch (ExecutionException failure) {
                    if (!(failure.getCause() instanceof RejectedExecutionException)) throw failure;
                    System.out.println("overload=rejected");
                }
            } finally {
                release.countDown();
            }
            System.out.println("query=" + first.get(5, TimeUnit.SECONDS));
            System.out.println("available=" + gate.available());
        }
    }
}
build.gradle
plugins { id 'application' }
repositories { mavenCentral() }
dependencies {
    implementation 'com.zaxxer:HikariCP:7.1.0'
    runtimeOnly 'org.postgresql:postgresql:42.7.14'
    runtimeOnly 'org.slf4j:slf4j-simple:2.0.20'
}
sourceSets.main.java {
    srcDirs = ['.']
    include 'DbBulkhead.java', 'Demo.java', 'DbBulkheadChecks.java'
}
tasks.withType(JavaCompile).configureEach { options.release = 21 }
application { mainClass = 'Demo' }
tasks.register('copyDependencies', Copy) {
    from configurations.runtimeClasspath
    into layout.buildDirectory.dir('deps')
}
tasks.register('contracts', JavaExec) {
    classpath = sourceSets.main.runtimeClasspath
    mainClass = 'DbBulkheadChecks'
}
settings.gradle
rootProject.name = 'virtual-threads-db-semaphore'Exécution locale
Enregistrer les quatre fichiers ci-dessus dans un répertoire d’expérimentation distinct, avec Docker, JDK 21 et Gradle 8.14.3 installés. Gradle s’exécute sous JDK 21 pour télécharger les dépendances. La compilation et l’exécution utilisent ensuite directement javac et java du JDK choisi : tester JDK 25 ne nécessite donc pas d’exécuter Gradle 8.14.3 sous JDK 25. Exécuter Gradle lui-même sous JDK 21 exige la version 8.5 ou ultérieure ; cette expérience utilise 8.14.3. Prise en charge de Java 21 pour l’exécution de Gradle
Exécuter les commandes suivantes dans un shell POSIX. JAVA_HOME doit pointer vers le JDK à exécuter ; choisir JDK 21 pour l’étape de téléchargement des dépendances. Le mot de passe de l’exemple est réservé à la base locale temporaire. Si le port 55432 est déjà utilisé, choisir un autre port.
(
  set -eu
  gradle --no-daemon -q copyDependencies
  db_container=$(docker run -d --rm -p 127.0.0.1:55432:5432 \
    -e POSTGRES_USER=demo -e POSTGRES_DB=demo \
    -e POSTGRES_PASSWORD=example-only \
    postgres@sha256:839fbb5a4942a7758dd93e18b42ea5649807491a0545b5eeeb8f0b8bb11857a5)
  trap 'docker stop "$db_container" >/dev/null' EXIT
  ready=false
  for attempt in $(seq 1 30); do
    if docker exec "$db_container" pg_isready -h 127.0.0.1 -U demo -d demo >/dev/null 2>&1; then
      ready=true
      break
    fi
    sleep 1
  done
  if [ "$ready" != true ]; then exit 1; fi
  mkdir -p build/classes
  "$JAVA_HOME/bin/javac" --release 21 -cp 'build/deps/*' \
    -d build/classes DbBulkhead.java Demo.java
  DB_URL='jdbc:postgresql://127.0.0.1:55432/demo?connectTimeout=2&socketTimeout=5' \
    DB_USER=demo DB_PASSWORD=example-only \
    "$JAVA_HOME/bin/java" -cp 'build/classes:build/deps/*' Demo
)
La sortie standard observée localement était la suivante. Les journaux de démarrage et d’arrêt de HikariCP peuvent apparaître séparément.
overload=rejected
query=42
available=1
L’environnement de vérification comprenait Temurin 21.0.13+9 et 25.0.5+8, PostgreSQL 17.11, HikariCP 7.1.0 et pgJDBC 42.7.14. Des contrôles complémentaires ont vérifié 45 conditions sur chaque JDK : commit et rollback, admission excédentaire, attentes expirées ou interrompues, poursuite du travail après annulation, reprise après un dépassement du délai d’une instruction côté serveur, épuisement du pool et récupération des permis après des échecs répétés. Aucun test de charge HTTP ni mesure du débit en production n’a été réalisé.
Frontières à préserver avec les délais et les transactions Spring
Séparer les délais d’attente des délais du travail. Dans l’exemple, queueWait limite uniquement l’attente d’un permis d’exécution. L’acquisition dans le pool, les attentes SQL et de verrous, le réseau et le nettoyage disposent de budgets distincts. Une échéance globale de requête exige une conception supplémentaire pour transmettre le temps restant à chaque étape. Cet exemple ne met pas en œuvre cette propagation de l’échéance de bout en bout.
Dans PostgreSQL, statement_timeout limite le temps d’exécution d’une instruction sur le serveur, tandis que lock_timeout limite l’attente d’acquisition des verrous. L’expérience a défini SET LOCAL statement_timeout = '100ms' dans une transaction, contrôlé que pg_sleep(2) échouait avec le SQLState 57014, puis vérifié que le travail suivant pouvait s’exécuter. Choisir les valeurs réelles en fonction des requêtes et des échéances. Réglages des délais dans PostgreSQL 17
Ni Future.cancel(true) ni la fin d’une requête HTTP ne garantit l’arrêt immédiat d’une requête JDBC. pgJDBC prévoit des limites distinctes pour les requêtes, la transmission du signal d’annulation et les lectures sur socket. Fermer une connexion après un dépassement du délai de socket ne revient pas non plus à confirmer que le travail côté serveur est arrêté. La frontière d’exécution conserve la responsabilité des permis pendant l’annulation et le nettoyage. Lorsque le résultat d’une écriture est incertain, utiliser une clé d’idempotence ou interroger le résultat pour décider d’une éventuelle relance. Propriétés de connexion de pgJDBC
Avec Spring, obtenir l’admission avant de démarrer la transaction. Une méthode d’entrée non transactionnelle dans un bean distinct peut passer par la barrière avant d’appeler un proxy transactionnel ; il est aussi possible d’exécuter un TransactionTemplate dans le périmètre admis. Libérer les permis après que l’appel au proxy ou le template a terminé le commit et le nettoyage, puis a rendu la main. Attendre dans une méthode dont la transaction a déjà commencé peut retenir des ressources appartenant à la transaction externe. Ne pas intégrer directement le code ci-dessus, qui gère lui-même les ressources JDBC, dans une transaction Spring existante.
REQUIRES_NEW peut nécessiter une autre connexion tout en conservant celle de la transaction externe. Cela rompt l’hypothèse de cet exemple, qui prévoit une connexion par opération, et peut provoquer un épuisement du pool ou une attente en interblocage. La barrière n’est pas non plus réentrante ; ne pas acquérir récursivement la même barrière. Propagation des transactions Spring et avertissement sur l’épuisement du pool
En production, compter séparément les rejets dus à une admission pleine et les dépassements du délai d’attente, et observer ensemble l’attente à la barrière, l’attente du pool, la durée de détention des connexions, la durée SQL et les attentes de verrous. Lorsque les rejets sont traduits en HTTP 503 ou en une autre réponse, définir des budgets de relance côté client pour éviter que des tentatives illimitées n’amplifient la charge. Ne pas augmenter B sur la seule base du nombre de rejets ; décider à partir de la latence et de la saturation de la base.
Discussion