Instala y utiliza un LLM en casa con Ollama
En esta página
Para usar un LLM personal en casa, empieza por instalar Ollama, descargar un modelo para tu PC y conectarlo a una tarea pequeña. Este artículo se centra en conversaciones en coreano y resúmenes de notas cortas; las instrucciones y la nota de ejemplo están en coreano. Adapta la ejecución e instrucciones de un modelo existente, sin entrenarlo desde cero.
Primero conversa con un modelo local en Ollama y después llama al mismo modelo desde Python para resumir una nota. Las explicaciones de instalación y API se basan en documentación oficial consultada el 5 de noviembre de 2026. Inicio rápido de Ollama
¿Basta con memoria igual al tamaño del archivo del modelo?
El modelo de ejemplo es qwen3:4b-instruct-2507-q4_K_M. Ollama lo presenta como un modelo Q4_K_M de unos 2.5GB. Q4_K_M es un formato de cuantización que representa los pesos con menos bits. El tamaño del archivo no es toda la memoria necesaria para ejecutar el modelo. Archivos y licencia del modelo
Durante la ejecución se necesita, además de los pesos, una caché KV para el contexto y otros recursos; el sistema operativo y las demás aplicaciones también consumen memoria. Un contexto mayor aumenta el consumo, por lo que el ejemplo fija num_ctx en 4096. Esto no significa que un PC doméstico pueda usar el contexto máximo del modelo. Contexto y memoria en Ollama
| Recurso | Qué considerar |
|---|---|
| GPU o memoria unificada | Distingue la VRAM de una GPU externa de la RAM del sistema. Apple Silicon comparte memoria unificada con otras aplicaciones. |
| Memoria disponible durante la ejecución | Si es insuficiente, empieza por un modelo menor o un contexto más corto. No interpretes el tamaño del archivo como RAM mínima requerida. |
| Espacio libre en disco | Reserva espacio para modelos y descargas adicionales. Guardar varios modelos aumenta el uso. |
| Compatibilidad de GPU y controladores | Comprueba que el sistema operativo y el dispositivo sean compatibles antes de elegir el modelo. |
La documentación de Ollama para macOS exige macOS 14 o posterior y admite CPU/GPU en dispositivos Apple de la serie M y CPU en Mac Intel. Windows requiere Windows 10 22H2 o posterior y controladores según la GPU. Antes de comprar hardware, comprueba velocidad de respuesta y memoria de una tarea pequeña en tu PC actual. Requisitos de macOS, requisitos de Windows, compatibilidad de GPU
Instalar y configurar el funcionamiento solo local
En macOS o Windows descarga el instalador de la página oficial y ejecuta la aplicación. En Linux usa el comando de la documentación oficial. El comando Linux siguiente instala software y un servicio, así que ejecútalo en el PC donde se instalará Ollama. Instalación en Linux
curl -fsSL https://ollama.com/install.sh | shDespués de instalar, comprueba la versión en una terminal nueva. Si la aplicación o el servicio ya ejecuta el servidor, no hace falta iniciar otro ollama serve.
ollama --versionPara procesar datos personales localmente, comprueba tanto el modelo como la configuración del servidor. Ollama también puede llamar modelos en la nube mediante su API local. Una dirección localhost por sí sola no determina dónde se ejecuta la inferencia. API local y modelos en la nube
En la aplicación de usuario de macOS o Windows, añade el ajuste siguiente en ~/.ollama/server.json de la cuenta que ejecuta el servidor. En Windows ~ significa el directorio personal del usuario. Si el archivo ya existe, añade la entrada conservando los demás ajustes y reinicia la aplicación. Esto desactiva los modelos en la nube y la búsqueda web; comprueba Ollama cloud disabled: true en el registro del servidor. Instalar y descargar el modelo requiere conexión a internet. Configuración solo local
{
  "disable_ollama_cloud": true
}
En Linux, el servicio systemd puede ejecutarse con otra cuenta distinta de la del usuario conectado. En ese caso configura sus variables con sudo systemctl edit ollama.service. Guarda la configuración siguiente y reinicia el servicio. Configuración del servicio Linux
[Service]
Environment="OLLAMA_NO_CLOUD=1"
Environment="OLLAMA_HOST=127.0.0.1:11434"
sudo systemctl daemon-reload
sudo systemctl restart ollama.serviceSi ejecutas el servidor directamente sin servicio, mantén abierto el shell POSIX que ejecuta OLLAMA_NO_CLOUD=1 OLLAMA_HOST=127.0.0.1:11434 ollama serve. No inicies otro servidor si ya hay uno funcionando. En ambos casos confirma que la nube está desactivada antes de introducir datos personales.
Descarga el modelo de ejemplo e inicia una conversación con el comando siguiente. Es una variante sin pensamiento, por lo que no se añade una opción de thinking. Las etiquetas cortas pueden apuntar a otras variantes; usa la etiqueta completa. Ficha del modelo Qwen
ollama pull qwen3:4b-instruct-2507-q4_K_M
ollama run qwen3:4b-instruct-2507-q4_K_M
Una primera pregunta podría ser: «한국어로 답해 줘. 내가 적은 메모를 요약할 때 확인할 기준 세 가지를 알려 줘» («Responde en coreano. Dame tres criterios para revisar al resumir una nota que he escrito»). Comprueba que la respuesta esté en coreano y respete el alcance, y termina con /bye. En otra terminal, consulta el ID con ollama list y la distribución CPU/GPU y memoria con ollama ps. Registra la versión de Ollama, el ID y la etiqueta para poder comparar diferencias posteriores. Comprobar el estado del modelo
Definir instrucciones predeterminadas para tu uso
Guarda el siguiente archivo en un directorio vacío. FROM selecciona el modelo base y SYSTEM fija sus instrucciones. num_predict limita los tokens generados y temperature afecta a la aleatoriedad. Los valores son ejemplos para resúmenes cortos. Una temperatura baja no garantiza exactitud factual. Sintaxis Modelfile
Modelfile
FROM qwen3:4b-instruct-2507-q4_K_M
PARAMETER num_ctx 4096
PARAMETER num_predict 512
PARAMETER temperature 0.2
SYSTEM """
한국어로 간결하게 답하세요.
제공된 자료에서 확인할 수 없는 내용은 추측하지 말고 모른다고 말하세요.
원문에 있는 사실과 제안을 구분하세요.
"""
Crea una configuración de modelo llamada home-assistant con el comando siguiente:
ollama create home-assistant -f Modelfile
ollama run home-assistant
Cambiar las instrucciones no enseña conocimientos nuevos al modelo ni le permite leer archivos de tu disco. Incluye el material pertinente en la solicitud, como en el siguiente ejemplo. Si hay muchos documentos, puedes diseñar por separado generación aumentada por recuperación (RAG) para buscar y aportar fragmentos. Comprueba primero la calidad del resumen de un archivo corto.
Resumir una nota elegida con Python
Este ejemplo usa solo la biblioteca estándar de Python 3. Lee un archivo guardado, lo envía a 127.0.0.1:11434/api/chat e imprime el resultado. No usa la configuración HTTP proxy del entorno ni proporciona herramientas al modelo para explorar archivos o ejecutar comandos.
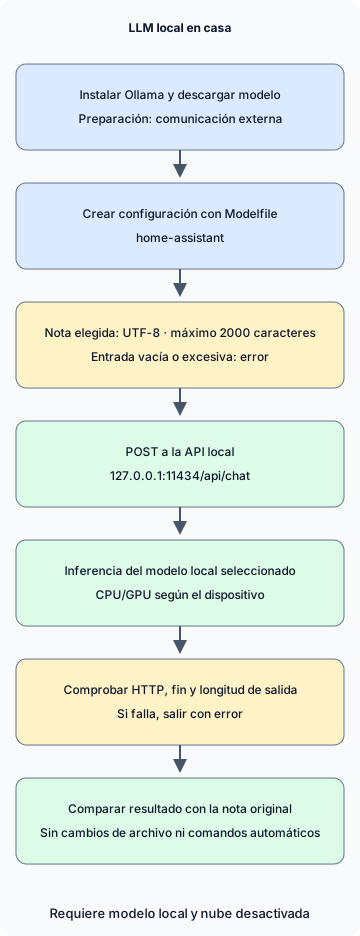
En el diagrama, instalar y descargar el modelo son pasos de preparación con comunicación externa. La inferencia posterior supone que se ha seleccionado un modelo local y desactivado la nube. Si falla la validación de entrada o respuesta, el programa termina con error sin emitir un resumen.
notes.txt
2026-11-05 집 서버 정리
결정: 사진 백업용 디스크 상태를 주말에 점검한다.
후속 작업: 작업 전 복구 테스트 방법을 찾아본다.
담당자와 정확한 시각은 정하지 않았다.
summarize.py
import json
from pathlib import Path
import sys
from urllib.request import ProxyHandler, Request, build_opener

ENDPOINT = "http://127.0.0.1:11434/api/chat"
MODEL = "home-assistant"
MAX_CHARS = 2000


def summarize(path):
    text = path.read_text(encoding="utf-8")
    if not text.strip() or len(text) > MAX_CHARS:
        raise ValueError(f"메모는 비어 있지 않은 {MAX_CHARS}자 이하의 UTF-8 텍스트여야 합니다.")
    prompt = (
        "다음 메모의 결정 사항과 후속 작업을 나누어 한국어로 요약하세요. "
        "원문에 없는 담당자나 기한을 추가하지 마세요.\n\n<자료>\n"
        + text + "\n</자료>"
    )
    payload = {
        "model": MODEL,
        "messages": [{"role": "user", "content": prompt}],
        "stream": False,
        "options": {"num_ctx": 4096, "num_predict": 512},
        "keep_alive": 0,
    }
    request = Request(
        ENDPOINT,
        data=json.dumps(payload, ensure_ascii=False).encode("utf-8"),
        headers={"Content-Type": "application/json"},
        method="POST",
    )
    opener = build_opener(ProxyHandler({}))
    with opener.open(request, timeout=120) as response:
        result = json.load(response)
    message = result.get("message") if isinstance(result, dict) else None
    answer = message.get("content") if isinstance(message, dict) else None
    if not isinstance(answer, str) or not answer.strip() or result.get("done") is not True:
        raise RuntimeError("완료된 텍스트 응답을 받지 못했습니다.")
    if result.get("done_reason") == "length":
        raise RuntimeError("출력 길이 제한에 도달했습니다. 메모나 요청 범위를 줄이세요.")
    return answer


if __name__ == "__main__":
    if len(sys.argv) != 2:
        raise SystemExit("사용법: python3 summarize.py notes.txt")
    try:
        print(summarize(Path(sys.argv[1])))
    except (OSError, ValueError, RuntimeError) as error:
        print(f"요약 실패: {error}", file=sys.stderr)
        raise SystemExit(1)
Guarda ambos archivos en la misma carpeta y ejecútalos. En Windows usa py -3 en vez de python3 según tu instalación de Python.
python3 summarize.py notes.txtstream: false solicita una única respuesta JSON. El ejemplo rechaza la entrada vacía o superior a 2000 caracteres y trata los errores HTTP, las respuestas inválidas y los límites de longitud de salida como errores. Un límite de caracteres no es un recuento exacto de tokens, así que comprueba que entrada y respuesta quepan en el contexto. keep_alive: 0 solicita descargar el modelo de memoria tras procesar, por lo que repeticiones pueden necesitar volver a cargarlo. API de chat y campos de respuesta
El tratamiento normal y de errores del cliente se comprobó con un servidor HTTP simulado local en Python 3.13.0. La instalación de Ollama, construcción de Modelfile, descarga, velocidad de inferencia y calidad del resumen no se ejecutaron ni verificaron en el entorno de preparación del artículo. Tras instalar, compara el resultado con la nota anterior. El tiempo límite de red de 120 segundos no confirma que el servidor haya detenido la tarea del modelo.
Comprueba tres cosas: si la revisión del disco sigue siendo una decisión, si la búsqueda de un método de prueba de recuperación se separa como tarea posterior y si el modelo evita inventar una persona responsable o una hora exacta. La fluidez y la fidelidad al original se evalúan por separado.
Elegir tareas diarias y criterios para detenerse
| Tarea | Entrada pequeña inicial | Comprobar antes de usar |
|---|---|---|
| Organizar notas personales | Una nota corta de reunión o estudio | ¿Se distinguen decisiones, propuestas y puntos pendientes? |
| Mejorar un borrador | Un párrafo escrito por ti y el estilo deseado | ¿Se conservan significado, cifras y fuentes? |
| Entender código | Un ejemplo público o función pequeña que se pueda compartir | ¿Coincide la explicación con el código y resultados? |
Este cliente solo imprime respuestas; no modifica archivos ni ejecuta comandos de shell. Si lo amplías a un agente que ejecuta automáticamente los comandos generados, diseña por separado permisos y aprobaciones, como en límites de permisos de agentes de IA. Un modelo local también puede verse afectado por instrucciones maliciosas en documentos y producir respuestas incorrectas.
La API escucha por defecto en una dirección local y no exige autenticación local. Empieza en un solo PC y no expongas el puerto 11434 mediante reenvío de puertos del router. El acceso de familiares u otros dispositivos requiere una configuración separada con autenticación y alcance definidos. Comprueba también si aplicaciones conectadas, plugins, registros o copias almacenan o transmiten datos externamente; la inferencia local no responde por sí sola a ello. Enlace predeterminado, alcance de autenticación
Si las respuestas son lentas, comprueba con ollama ps la distribución CPU/GPU y la memoria usada por otras aplicaciones. Reduce entradas largas y contextos grandes y vuelve a comparar la misma tarea. Si se rechaza la conexión, comprueba la aplicación o servicio. Si no se encuentra el modelo, consulta ollama list y comprueba si se creó home-assistant. En vez de acumular solicitudes agotadas por tiempo, revisa primero el trabajo en ejecución.
Mantén unas pocas notas fijas y compara omisiones, suposiciones y tiempos de espera al cambiar modelo o ajustes.
Comentarios