Установите и используйте LLM дома с Ollama
На этой странице
Чтобы использовать персональную LLM дома, начните с установки Ollama, загрузки модели для своего ПК и подключения одной небольшой задачи. Статья посвящена диалогу на корейском и краткому изложению заметок; инструкции и пример заметки приведены на корейском. Мы адаптируем запуск и инструкции существующей модели, а не обучаем её с нуля.
Сначала попробуем общаться с локальной моделью Ollama, затем вызовем ту же модель из Python для краткого изложения заметки. Описание установки и API основано на официальной документации, проверенной 5 ноября 2026 года. Быстрый старт Ollama
Достаточно ли памяти размером с файл модели?
Модель примера — qwen3:4b-instruct-2507-q4_K_M. В Ollama указана модель Q4_K_M размером около 2.5GB. Q4_K_M — формат квантования, представляющий веса меньшим числом бит. Размер файла не равен всей памяти, необходимой для запуска модели. Файлы и лицензия модели
Во время выполнения кроме весов нужны KV-кеш контекста диалога и другие ресурсы; ОС и приложения также потребляют память. Увеличение контекста повышает расход, поэтому пример задаёт num_ctx равным 4096. Это не означает, что домашний ПК сможет использовать максимальный контекст модели. Контекст и память Ollama
| Ресурс | Что учитывать |
|---|---|
| Память GPU или объединённая память | Различайте VRAM внешней GPU и системную RAM. Apple Silicon делит объединённую память с другими приложениями. |
| Память, доступная во время работы | При нехватке начните с меньшей модели или короткого контекста. Не считайте размер файла минимальным требованием RAM. |
| Свободное место на диске | Учитывайте файлы модели и дополнительные загрузки. Несколько моделей занимают больше места. |
| Поддержка GPU и драйверов | До выбора модели проверьте поддержку текущих ОС и устройства. |
Документация Ollama для macOS указывает macOS 14 или новее и поддержку CPU/GPU на устройствах Apple серии M и CPU на Intel Mac. Windows требует Windows 10 22H2 или новее и драйверы в зависимости от GPU. Прежде чем покупать оборудование, проверьте скорость ответа и расход памяти небольшой задачи на текущем ПК. Требования macOS, требования Windows, поддержка GPU
Установка и настройка только локальной работы
На macOS или Windows скачайте установщик с официальной страницы и запустите приложение. На Linux используйте команду из официальной документации. Команда Linux ниже устанавливает программу и службу, поэтому запускайте её на ПК, где нужна Ollama. Установка Linux
curl -fsSL https://ollama.com/install.sh | shПосле установки проверьте версию в новом терминале. Если приложение или служба уже запустили сервер, повторно запускать ollama serve не нужно.
ollama --versionДля локальной обработки личных данных проверяйте и модель, и настройки сервера. Ollama может вызывать облачные модели через локальный API. Адрес localhost сам по себе не определяет место выполнения инференса. Локальный API и облачные модели
В пользовательском приложении macOS или Windows добавьте настройку ниже в ~/.ollama/server.json аккаунта, запускающего сервер. В Windows ~ означает домашнюю папку пользователя. Если файл уже существует, сохраните остальные настройки, добавьте пункт и перезапустите приложение. Облачные модели и веб-поиск отключатся; убедитесь в применении по Ollama cloud disabled: true в журнале сервера. Для установки и загрузки модели нужен интернет. Настройка только локальной работы
{
  "disable_ollama_cloud": true
}
В Linux служба systemd может работать под аккаунтом, отличным от вошедшего пользователя. Тогда задайте переменные службы через sudo systemctl edit ollama.service. Сохраните конфигурацию ниже и перезапустите службу. Настройка службы Linux
[Service]
Environment="OLLAMA_NO_CLOUD=1"
Environment="OLLAMA_HOST=127.0.0.1:11434"
sudo systemctl daemon-reload
sudo systemctl restart ollama.serviceПри прямом запуске без службы оставьте открытым POSIX shell с OLLAMA_NO_CLOUD=1 OLLAMA_HOST=127.0.0.1:11434 ollama serve. Не запускайте ещё один сервер, если первый уже работает. В обоих случаях перед вводом личных данных подтвердите отключение облачных функций.
Следующей командой загрузите модель и начните диалог. Это вариант без thinking, поэтому отдельный параметр thinking не добавляется. Короткие теги могут указывать на другие варианты, поэтому используйте полный тег. Карточка модели Qwen
ollama pull qwen3:4b-instruct-2507-q4_K_M
ollama run qwen3:4b-instruct-2507-q4_K_M
Первый вопрос может быть таким: «한국어로 답해 줘. 내가 적은 메모를 요약할 때 확인할 기준 세 가지를 알려 줘» («Ответь на корейском. Назови три критерия для проверки при кратком изложении моей заметки»). Проверьте корейский язык и соблюдение задачи, затем завершите диалог через /bye. В другом терминале проверьте ID модели через ollama list, размещение CPU/GPU и память — через ollama ps. Запишите версию Ollama, ID и тег модели для сравнения будущих результатов. Проверка работы модели
Задаём стандартные инструкции для своей задачи
Сохраните следующий файл в пустой рабочей папке. FROM выбирает базовую модель, а SYSTEM задаёт стандартные инструкции. num_predict ограничивает число генерируемых токенов, temperature влияет на случайность. Значения приведены для коротких заметок. Низкая температура не гарантирует фактическую точность. Синтаксис Modelfile
Modelfile
FROM qwen3:4b-instruct-2507-q4_K_M
PARAMETER num_ctx 4096
PARAMETER num_predict 512
PARAMETER temperature 0.2
SYSTEM """
한국어로 간결하게 답하세요.
제공된 자료에서 확인할 수 없는 내용은 추측하지 말고 모른다고 말하세요.
원문에 있는 사실과 제안을 구분하세요.
"""
Создайте конфигурацию модели home-assistant следующей командой:
ollama create home-assistant -f Modelfile
ollama run home-assistant
Изменение инструкций само по себе не обучает модель новым знаниям и не даёт ей читать файлы с диска. Передавайте нужный материал в запросе, как в следующем примере. Для множества документов можно отдельно спроектировать генерацию с поиском (RAG), подбирающую и передающую нужные фрагменты. Сначала проверьте качество краткого изложения одного короткого файла.
Кратко излагаем одну заметку через Python
Пример использует только стандартную библиотеку Python 3. Он читает сохранённый файл, отправляет его на 127.0.0.1:11434/api/chat и выводит результат. Настройки HTTP-прокси окружения не используются; модель не получает инструменты просмотра файлов или выполнения команд.
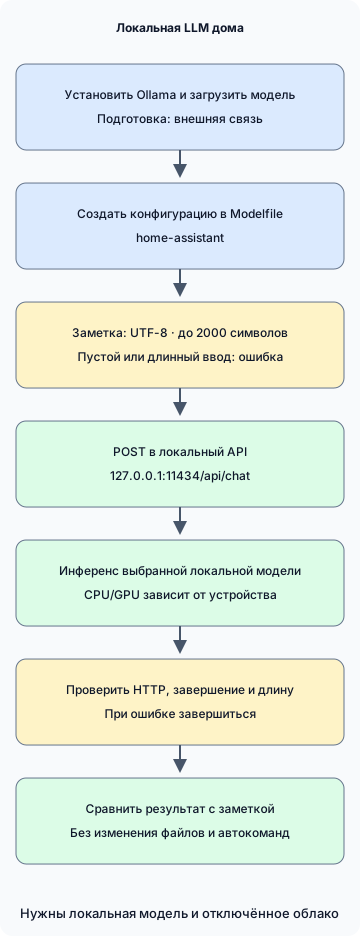
На диаграмме установка и загрузка модели — подготовка с внешним соединением. Последующий инференс предполагает выбранную локальную модель и отключённые облачные функции. При ошибке проверки входа или ответа программа завершится с ошибкой без вывода краткого изложения.
notes.txt
2026-11-05 집 서버 정리
결정: 사진 백업용 디스크 상태를 주말에 점검한다.
후속 작업: 작업 전 복구 테스트 방법을 찾아본다.
담당자와 정확한 시각은 정하지 않았다.
summarize.py
import json
from pathlib import Path
import sys
from urllib.request import ProxyHandler, Request, build_opener

ENDPOINT = "http://127.0.0.1:11434/api/chat"
MODEL = "home-assistant"
MAX_CHARS = 2000


def summarize(path):
    text = path.read_text(encoding="utf-8")
    if not text.strip() or len(text) > MAX_CHARS:
        raise ValueError(f"메모는 비어 있지 않은 {MAX_CHARS}자 이하의 UTF-8 텍스트여야 합니다.")
    prompt = (
        "다음 메모의 결정 사항과 후속 작업을 나누어 한국어로 요약하세요. "
        "원문에 없는 담당자나 기한을 추가하지 마세요.\n\n<자료>\n"
        + text + "\n</자료>"
    )
    payload = {
        "model": MODEL,
        "messages": [{"role": "user", "content": prompt}],
        "stream": False,
        "options": {"num_ctx": 4096, "num_predict": 512},
        "keep_alive": 0,
    }
    request = Request(
        ENDPOINT,
        data=json.dumps(payload, ensure_ascii=False).encode("utf-8"),
        headers={"Content-Type": "application/json"},
        method="POST",
    )
    opener = build_opener(ProxyHandler({}))
    with opener.open(request, timeout=120) as response:
        result = json.load(response)
    message = result.get("message") if isinstance(result, dict) else None
    answer = message.get("content") if isinstance(message, dict) else None
    if not isinstance(answer, str) or not answer.strip() or result.get("done") is not True:
        raise RuntimeError("완료된 텍스트 응답을 받지 못했습니다.")
    if result.get("done_reason") == "length":
        raise RuntimeError("출력 길이 제한에 도달했습니다. 메모나 요청 범위를 줄이세요.")
    return answer


if __name__ == "__main__":
    if len(sys.argv) != 2:
        raise SystemExit("사용법: python3 summarize.py notes.txt")
    try:
        print(summarize(Path(sys.argv[1])))
    except (OSError, ValueError, RuntimeError) as error:
        print(f"요약 실패: {error}", file=sys.stderr)
        raise SystemExit(1)
Сохраните оба файла в одной папке и запустите. В Windows используйте py -3 вместо python3 в зависимости от установки Python.
python3 summarize.py notes.txtstream: false запрашивает единый JSON-ответ. Пример отклоняет пустой ввод и ввод более 2000 символов; HTTP-ошибки, неверный ответ и ограничения длины вывода считаются ошибками. Ограничение символов не равно точному подсчёту токенов, поэтому проверяйте, что вход и ответ помещаются в контекст. keep_alive: 0 запрашивает выгрузку модели из памяти после обработки, поэтому при повторах может понадобиться повторная загрузка. API чата и поля ответа
Нормальная обработка и ошибки клиента проверены через локальный тестовый HTTP-сервер на Python 3.13.0. Установка Ollama, сборка Modelfile, загрузка модели, скорость инференса и качество краткого изложения в среде подготовки статьи не запускались и не проверялись. После установки сравните результат с заметкой выше. Сетевой тайм-аут 120 секунд не подтверждает остановку задачи модели на сервере.
Проверьте три вещи: осталась ли проверка состояния диска принятым решением, выделен ли поиск метода проверки восстановления в последующую задачу и не выдумала ли модель ответственного или точное время. Гладкость текста и верность исходнику оцениваются отдельно.
Выбираем повседневные задачи и критерии остановки
| Задача | Небольшой исходный материал | Проверка перед применением |
|---|---|---|
| Упорядочить личные заметки | Одна короткая заметка о встрече или учёбе | Различаются ли решения, предложения и нерешённые пункты? |
| Улучшить черновик | Свой абзац и желаемый стиль | Сохранены ли смысл, числа и источники? |
| Понять код | Публичный пример или небольшая функция, которой можно делиться | Соответствует ли объяснение коду и результатам выполнения? |
Клиент только печатает ответы; он не меняет файлы и не выполняет команды shell. Если расширить его до агента, автоматически выполняющего сгенерированные команды, отдельно спроектируйте разрешения и подтверждения, как описано в границах разрешений ИИ-агента. Локальная модель тоже подвержена вредоносным инструкциям в документах и может давать неверные ответы.
По умолчанию API слушает локальный адрес, а локальная аутентификация не требуется. Начните с одного ПК и не открывайте порт 11434 через проброс маршрутизатора. Доступ членов семьи или других устройств требует отдельной конфигурации с определёнными аутентификацией и границами доступа. Также проверьте, сохраняют или отправляют ли данные вовне подключённые приложения, плагины, журналы и резервные копии; локальный инференс сам по себе на этот вопрос не отвечает. Адрес по умолчанию, область аутентификации
Если ответы медленные, сначала проверьте размещение CPU/GPU через ollama ps и память других приложений. Сократите длинный ввод и большой контекст, затем сравните ту же задачу. При отказе соединения проверьте запуск приложения или службы. Если модель не найдена, проверьте ollama list и создание home-assistant. Вместо накопления запросов с тайм-аутом сначала проверьте уже выполняющуюся работу.
Закрепите несколько заметок и сравнивайте пропуски, догадки и время ожидания при изменении модели или настроек.
Обсуждение