Repli en cas de panne : des réponses correctes à coût borné
Sur cette page
Pendant une panne, le repli doit fournir une réponse à un niveau de qualité acceptable prédéfini et à un coût supportable pour le système. Vous pouvez omettre une section de recommandations ou retourner des données publiques dans une limite d’âge convenue. Annoncer un succès lorsque le résultat d’un paiement est inconnu, ou envoyer chaque requête à la base quand le cache tombe, crée d’autres problèmes.
Cet article est un guide de conception pour les développeurs exploitant des API HTTP. Après les contrôles de surcharge de l’article sur l’architecture à 10k RPS, il aborde les réponses à retourner pendant les pannes. L’exemple Java exécute une politique de repli sans serveur externe ; il ne mesure ni débit ni récupération après une panne de production.
Des pannes différentes autorisent des résultats différents
Décidez d’abord de ce qui peut être réduit dans le résultat normal. Les éléments suivants sont des exemples de conception ; les limites d’âge réelles et le périmètre fonctionnel réduit doivent suivre le contrat de votre service.
| Panne | Alternative acceptable | Quand arrêter ou limiter |
|---|---|---|
| Retard ou échec de l’API de recommandations | Omettre les recommandations facultatives ou utiliser des recommandations générales préparées | Ne pas placer les lectures produit essentielles dans la même file |
| Échec de lecture d’une description publique de produit | Retourner les dernières données réussies du même produit et de la même langue avec leur date de mise à jour | Âge maximal dépassé, données absentes ou clé incorrecte |
| Cache entièrement indisponible | Lectures source limitées, copie locale approuvée ou refus des requêtes excédentaires | Aucun contournement illimité au-delà des budgets de connexions et de concurrence de la base |
| Échec du contrôle d’authentification ou d’autorisation | Retourner une erreur temporaire sans réaliser l’opération protégée | Ne pas confondre panne et absence de permission ni remplacer la panne par une autorisation d’accès |
| Réponse perdue après une demande de paiement ou commande | Interroger le statut et rapprocher avec le même identifiant d’opération | Ne pas supposer un échec et créer un nouveau paiement, ni inventer un succès |
| Serveur alternatif utilisant la même base | Basculer uniquement dans une capacité vérifiée séparément | Changer de serveur ne résout pas un goulot dans la base partagée |
Séparez les parcours critiques pour la correction, comme l’autorisation, le prix final et la déduction de stock, des simples lectures périmées. Un statut de paiement « en cours de vérification » n’a de sens que si vous pouvez réellement suivre et interroger la requête. Renommer un message ou une réponse ne gère pas un résultat non résolu.
AWS décrit les tests insuffisants des parcours rarement utilisés et les problèmes supplémentaires introduits par les alternatives parmi les risques du repli dans les systèmes distribués. Exécutez les parcours de repli comme les parcours normaux et vérifiez s’ils dépendent des mêmes ressources.
Que font respectivement délais, nouvelles tentatives et disjoncteurs ?
Un délai limite la durée d’attente de l’appelant. La fin de cette attente ne signifie pas que l’opération distante ou le paiement a été annulé. Une nouvelle tentative réessaie la même opération, tandis que le basculement change de réplica. Le repli passe à une réponse réduite ou une autre méthode de traitement. Un disjoncteur bloque les appels à une dépendance dans des conditions définies après accumulation d’échecs ; une politique distincte détermine quelle réponse alternative est sûre.
L’échéance globale d’une requête doit inclure l’établissement de connexion, l’attente du pool, l’attente de réponse, les nouvelles tentatives et le traitement alternatif. Par exemple, si le budget total est de 300ms et que le premier appel a pris 250ms, vous ne pouvez pas attendre encore 250ms. Ces nombres illustrent l’idée et ne sont pas des réglages recommandés. Vérifiez aussi ce qu’inclut réellement le délai de chaque étape dans votre client.
Comme l’explique le guide AWS des nouvelles tentatives, celles-ci ajoutent de la charge, et des effets peuvent s’être produits même si la réponse échoue. Attribuez la responsabilité des nouvelles tentatives à une seule couche et bornez le temps restant et le nombre d’essais pour les échecs transitoires uniquement lorsque répéter l’opération est sûr. Le recul exponentiel et le jitter répartissent les nouvelles tentatives simultanées, mais n’augmentent pas la capacité d’une base saturée.
Exemple Java : retourner uniquement des données publiques approuvées pour un temps limité
L’exemple suivant lit une description publique de produit fixe. Il privilégie la réponse normale et n’utilise la dernière copie réussie que pour les échecs de dépendance classés Unavailable. La copie ne doit pas avoir plus de 60 secondes, et un horodatage futur est refusé. La limite de 2 et la fenêtre de 60 secondes sont des politiques de démonstration. Plusieurs produits, langues ou tenants exigent des clés distinctes ; ne réutilisez pas cet exemple de données fixes tel quel comme cache de données utilisateur authentifiées.
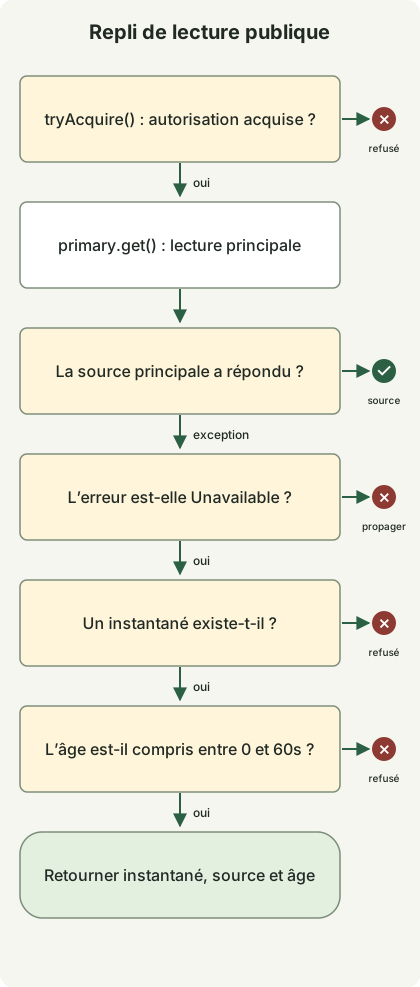
Le schéma montre les décisions de read(). Chaque parcours acquérant une autorisation la libère par finally, qu’il retourne un résultat principal ou lève une exception. Délais, disjoncteurs et actualisation du cache ne sont pas implémentés. Un véritable adaptateur HTTP ne doit traduire que les échecs approuvés, comme les échecs de connexion et délais dépassés, en Unavailable. Convertir 401, 403, 404, les erreurs de schéma et de programmation dans la même exception change le sens de cette politique.
Enregistrez ceci sous FallbackDemo.java. Il s’exécute avec JDK 21 ou ultérieur sans dépendances externes.
import java.time.Clock;
import java.time.Duration;
import java.time.Instant;
import java.time.ZoneOffset;
import java.util.concurrent.Semaphore;
import java.util.function.Supplier;

public class FallbackDemo {
    record Snapshot(String value, Instant observedAt) {}
    record Reply(String value, String source, long ageSeconds) {}
    static class Unavailable extends RuntimeException {}
    static class Rejected extends RuntimeException {
        Rejected(String reason) { super(reason); }
    }

    static final class Catalog {
        private final Semaphore slots = new Semaphore(2);
        private final Clock clock;
        private final Duration maxAge = Duration.ofSeconds(60);

        Catalog(Clock clock) { this.clock = clock; }

        Reply read(Supplier<String> primary, Snapshot snapshot) {
            if (!slots.tryAcquire()) throw new Rejected("capacity");
            try {
                try {
                    return new Reply(primary.get(), "primary", 0);
                } catch (Unavailable failure) {
                    if (snapshot == null) throw new Rejected("missing");
                    Duration age = Duration.between(
                            snapshot.observedAt(), clock.instant());
                    if (age.isNegative() || age.compareTo(maxAge) > 0) {
                        throw new Rejected("age");
                    }
                    return new Reply(snapshot.value(), "snapshot", age.toSeconds());
                }
            } finally {
                slots.release();
            }
        }
    }

    static void rejected(String reason, Runnable action) {
        try {
            action.run();
        } catch (Rejected e) {
            if (!reason.equals(e.getMessage())) throw new AssertionError(e);
            System.out.println("rejected=" + reason);
            return;
        }
        throw new AssertionError("Expected rejection: " + reason);
    }

    public static void main(String[] args) {
        Instant now = Instant.parse("2026-10-31T00:00:00Z");
        Catalog catalog = new Catalog(Clock.fixed(now, ZoneOffset.UTC));
        Snapshot recent = new Snapshot("saved-description", now.minusSeconds(30));
        Supplier<String> down = () -> { throw new Unavailable(); };

        System.out.println(catalog.read(() -> "live-description", recent));
        System.out.println(catalog.read(down, recent));
        System.out.println(catalog.read(down,
                new Snapshot("boundary", now.minusSeconds(60))));
        rejected("age", () -> catalog.read(down,
                new Snapshot("old", now.minusSeconds(60).minusNanos(1))));
        rejected("age", () -> catalog.read(down,
                new Snapshot("future", now.plusSeconds(1))));
        rejected("missing", () -> catalog.read(down, null));

        try {
            catalog.read(() -> { throw new IllegalStateException("schema"); }, recent);
            throw new AssertionError("Unexpected fallback");
        } catch (IllegalStateException expected) {
            System.out.println("propagated=" + expected.getMessage());
        }

        // Hold both permits through nested calls; the third call must not run.
        catalog.read(() -> catalog.read(() -> {
            rejected("capacity", () -> catalog.read(() -> {
                throw new AssertionError("Primary ran without a permit");
            }, recent));
            return "inner";
        }, recent).value(), recent);
        System.out.println(catalog.read(() -> "recovered", recent));
    }
}
javac --release 21 FallbackDemo.java
java FallbackDemoLa sortie suivante a été obtenue avec Zulu JDK 21.0.1+12-LTS.
Reply[value=live-description, source=primary, ageSeconds=0]
Reply[value=saved-description, source=snapshot, ageSeconds=30]
Reply[value=boundary, source=snapshot, ageSeconds=60]
rejected=age
rejected=age
rejected=missing
propagated=schema
rejected=capacity
Reply[value=recovered, source=primary, ageSeconds=0]
source=snapshot et ageSeconds sont des métadonnées applicatives signalant au client la qualité dégradée. Elles n’implémentent pas l’en-tête HTTP Age. La comparaison d’âge maximal utilise une Duration précise ; seul l’âge affiché est réduit aux secondes entières.
Le tryAcquire() de Semaphore échoue sans attendre si aucune autorisation n’est disponible. Cet exemple inclut les réponses de repli dans la même limite d’admission ; il ne retourne donc même pas de copie lorsqu’il est déjà saturé. Pour autoriser en production un parcours bon marché réservé aux copies, donnez-lui aussi sa propre limite. Les appels imbriqués démontrent un épuisement déterministe des autorisations ; ce n’est pas un test de charge concurrent.
L’exemple n’implémente pas le stockage et l’actualisation des lectures réussies, les limites de stockage et l’éviction, le regroupement des requêtes ou la restauration des copies après redémarrage. En production, n’actualisez les copies qu’à partir de lectures réussies et ne réécrivez pas l’horodatage stocké lorsque vous retournez une copie. Le mettre à jour à chaque réponse de repli peut rendre une ancienne valeur acceptable indéfiniment. Les copies durables nécessitent aussi une politique de fraîcheur tenant compte des corrections d’horloge.
Définir aussi les conditions de fin de panne
Le guide Google SRE de gestion de surcharge explique qu’une erreur peut être nécessaire lorsque même une réponse dégradée coûte trop cher. Si un refus d’admission ou l’absence de copie valide rend le service temporairement indisponible, vous pouvez utiliser 503 selon le contrat HTTP. Vous pouvez envoyer Retry-After s’il existe un délai fiable de nouvelle tentative, mais cet en-tête seul n’empêche pas un afflux de clients. 504 signifie qu’une passerelle ou un proxy n’a pas reçu de réponse à temps d’un serveur amont ; ce n’est pas un code pour chaque délai applicatif dépassé. RFC 9110
Renvoyer toutes les requêtes au service principal dès qu’un disjoncteur se referme peut de nouveau submerger un serveur en récupération. Vérifiez son état avec des appels de sonde limités en état semi-ouvert, puis augmentez progressivement le trafic en limitant aussi l’actualisation des instantanés et le remplissage du cache. Définissez à l’avance quand arrêter l’expansion ou revenir à l’étape précédente si la latence normale, le taux d’échec, l’attente des connexions de base ou l’accumulation en file dépassent les plages acceptables. Déterminez les proportions et périodes d’observation précises par de véritables tests de charge.
Pour un premier déploiement, choisissez un parcours de lecture facultatif et injectez des échecs de dépendance. Vérifiez ensuite les copies absentes, la limite d’âge autorisée, les horodatages futurs, la saturation complète de l’admission, les exceptions non classées et la reprise de la dépendance. Sur de vrais serveurs, testez aussi les réponses lentes et l’épuisement du pool, la panne complète du cache, les pannes simultanées des parcours principal et de repli, ainsi que les nouvelles tentatives simultanées pendant la reprise.
Séparez résultats normaux, résultats de repli, refus et échecs dans les métriques opérationnelles. Observer uniquement le taux HTTP 200 peut masquer une panne où la plupart des réponses sont périmées. Suivez ensemble la proportion de repli, l’âge des données, les échecs par dépendance, les refus d’admission et les requêtes en cours. Distinguez les requêtes achevant réellement la fonction métier de celles traitées avec une qualité réduite pour juger si le repli a réduit l’impact de la panne.
Discussion