Cache-Aside : comprendre clés, TTL, invalidation et pannes
Sur cette page
La mise en cache réutilise des résultats obtenus auparavant pour réduire les lectures à la source et les calculs. Pour l’appliquer correctement, définissez d’abord quelles requêtes peuvent partager un résultat, la durée de réutilisation permise et la manière d’actualiser ce résultat lorsque la source change. Un taux de succès élevé ne rend pas un cache correct s’il renvoie les données d’une autre personne ou utilise un ancien prix pour finaliser un achat.
Cet article s’adresse aux développeurs envisageant un cache pour une API de lecture. Il explique Cache-Aside avec des données tolérant un certain retard, comme les descriptions de produits, et exécute des limites de TTL et de capacité en Java. Les opérations exigeant l’état actuel, comme la finalisation d’un paiement ou du stock, sont distinctes de ce cache de lecture. Les politiques autorisant des données périmées pendant les pannes rejoignent l’article sur la conception du repli.
Que mettre en cache, et où ?
Commencez par les parcours aux lectures répétées, aux accès source coûteux et tolérant des réponses périmées pendant un temps limité. Des données utilisées une seule fois ou presque entièrement propres à chaque utilisateur peuvent coûter davantage à stocker et invalider que les succès du cache ne font économiser.
| Emplacement | Coûts qu’il peut réduire | Conditions à définir en parallèle |
|---|---|---|
| Cache HTTP dans un navigateur ou CDN | Allers-retours réseau et requêtes atteignant l’API | Partage autorisé ou non, URL et Vary, Cache-Control |
| Cache local à l’application | Allers-retours au cache distant, lectures de base, calculs répétés | Limite mémoire par processus, différences entre les valeurs des réplicas |
| Cache partagé tel que Redis | Lectures répétées à la source entre réplicas | Latence réseau, comportement en panne, sérialisation, capacité de stockage |
Toutes les couches ne sont pas nécessaires simultanément. Un cache local est rapide, mais chaque réplica détient une copie différente. Un cache partagé peut réduire le stockage en double, mais ajoute une dépendance réseau et opérationnelle. Avec plusieurs couches, l’invalidation doit aussi les atteindre toutes.
Comment fonctionne Cache-Aside ?
L’application consulte d’abord le cache. Si l’entrée est absente ou expirée, elle lit la source et stocke le résultat dans le cache. Ce flux s’appelle Cache-Aside. Les écritures valident généralement d’abord la modification à la source avant d’invalider l’entrée correspondante. Les données source survivent à la perte du cache ; cela diffère de l’utilisation du cache comme seul enregistrement. L’explication Microsoft de Cache-Aside
Une clé de cache doit inclure les entrées qui changent le résultat. Par exemple, Key(tenant, product, language) représente des entrées différentes selon les tenants, produits et langues. Si la devise, les permissions utilisateur ou la version du format de représentation changent aussi la réponse, séparez les clés ou le périmètre de cache en conséquence. Concaténer des chaînes sans séparateurs peut provoquer des collisions ; utilisez des clés structurées ou un encodage non ambigu.
Mettre un identifiant de tenant dans la clé ne suffit pas à l’autorisation. Déterminez le tenant depuis un contexte d’authentification fiable et vérifiez l’accès avant d’interroger le cache. Ne placez pas directement des tokens d’accès ou mots de passe dans les clés ou journaux.
Le TTL est la période pendant laquelle une valeur peut être réutilisée ; une limite de capacité est la quantité stockable. Avec le seul TTL, les entrées peuvent s’accumuler jusqu’à leur expiration. Avec une simple limite de taille, des valeurs périmées peuvent continuer à produire des succès. Le nombre d’entrées et leur taille réelle en octets diffèrent ; tenez donc compte des tailles des objets et de leur sérialisation pour les grandes réponses.
Exemple Java : isolation des clés, expiration, invalidation et capacité
Le code ci-dessous est une petite démonstration de la sémantique d’un cache local pour des descriptions de produits par tenant. Son TTL de 5 secondes et son maximum de 2 entrées servent à observer le comportement, pas à recommander des valeurs de production. Il utilise l’ordre d’accès de LinkedHashMap pour évincer d’abord l’entrée utilisée le moins récemment. Documentation Java 21
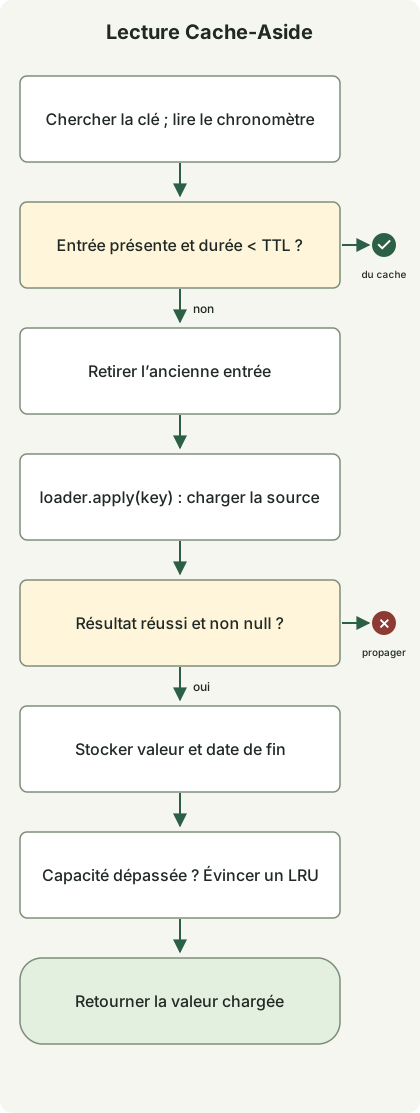
Le schéma montre get(). Si le chargeur source échoue, l’exception se propage et aucune nouvelle valeur n’est stockée. invalidate() est une opération distincte appelée après une modification de la source.
Enregistrez ce code sous CacheDemo.java et exécutez-le avec JDK 21 ou ultérieur. Aucun serveur ni bibliothèque externe n’est nécessaire.
import java.time.Duration;
import java.util.LinkedHashMap;
import java.util.Objects;
import java.util.concurrent.atomic.AtomicInteger;
import java.util.concurrent.atomic.AtomicLong;
import java.util.function.Function;
import java.util.function.LongSupplier;

public class CacheDemo {
    record Key(String tenant, String product, String language) {}
    record Entry(String value, long loadedAt) {}

    static final class LocalCache {
        private final LinkedHashMap<Key, Entry> entries =
                new LinkedHashMap<>(16, 0.75f, true);
        private final LongSupplier ticker;
        private final long ttl = Duration.ofSeconds(5).toNanos();
        private final int maximumSize = 2;

        LocalCache(LongSupplier ticker) { this.ticker = ticker; }

        synchronized String get(Key key, Function<Key, String> loader) {
            Entry entry = entries.get(key);
            long now = ticker.getAsLong();
            if (entry != null && now - entry.loadedAt() < ttl) {
                return entry.value();
            }
            entries.remove(key);
            String value = Objects.requireNonNull(loader.apply(key));
            entries.put(key, new Entry(value, ticker.getAsLong()));
            if (entries.size() > maximumSize) {
                entries.remove(entries.keySet().iterator().next());
            }
            return value;
        }

        synchronized void invalidate(Key key) { entries.remove(key); }
    }

    static void expect(String actual, String expected) {
        if (!actual.equals(expected)) throw new AssertionError(actual);
        System.out.println(actual);
    }

    public static void main(String[] args) {
        AtomicLong clock = new AtomicLong();
        AtomicInteger loads = new AtomicInteger();
        LocalCache cache = new LocalCache(clock::get);
        Function<Key, String> loader = key ->
                key.tenant() + "/" + key.language() + "/v" + loads.incrementAndGet();
        Key ko = new Key("shop-a", "p1", "ko");
        Key en = new Key("shop-a", "p1", "en");
        Key other = new Key("shop-b", "p1", "ko");

        expect(cache.get(ko, loader), "shop-a/ko/v1");
        expect(cache.get(ko, loader), "shop-a/ko/v1");
        clock.set(Duration.ofSeconds(5).toNanos() - 1);
        expect(cache.get(ko, loader), "shop-a/ko/v1");
        clock.incrementAndGet();
        expect(cache.get(ko, loader), "shop-a/ko/v2");
        cache.invalidate(ko);
        expect(cache.get(ko, loader), "shop-a/ko/v3");
        expect(cache.get(en, loader), "shop-a/en/v4");
        expect(cache.get(ko, loader), "shop-a/ko/v3");
        expect(cache.get(other, loader), "shop-b/ko/v5");
        expect(cache.get(en, loader), "shop-a/en/v6");

        Key failing = new Key("shop-c", "p1", "ko");
        try {
            cache.get(failing, key -> { throw new IllegalStateException("origin"); });
            throw new AssertionError("Failure was swallowed");
        } catch (IllegalStateException expected) {
            expect(expected.getMessage(), "origin");
        }
        expect(cache.get(failing, loader), "shop-c/ko/v7");
    }
}
javac --release 21 CacheDemo.java
java CacheDemoLa sortie suivante a été obtenue avec Zulu JDK 21.0.1+12-LTS.
shop-a/ko/v1
shop-a/ko/v1
shop-a/ko/v1
shop-a/ko/v2
shop-a/ko/v3
shop-a/en/v4
shop-a/ko/v3
shop-b/ko/v5
shop-a/en/v6
origin
shop-c/ko/v7
Les trois premières lectures de la même clé ne lisent la source qu’une fois. La même valeur est retournée 1ns avant expiration ; à exactement 5 secondes, elle est rechargée. Les cas suivants vérifient l’invalidation explicite, l’isolation des clés par langue et tenant et l’éviction selon l’ordre d’accès. Ils incluent aussi une lecture réussie après un échec du chargeur. Des valeurs telles que v1 indiquent la séquence d’appels du chargeur de test, et non de véritables versions de base.
Le temps est reproduit avec un chronomètre monotone avancé manuellement au lieu d’une attente. Dans un vrai processus, vous pouvez fournir un chronomètre de temps écoulé avec new LocalCache(System::nanoTime). L’exemple traite les entrées expirées à l’accès au lieu de les supprimer immédiatement en arrière-plan. Il limite le nombre d’entrées, pas les octets.
Pour garder le code court, le chargeur s’exécute aussi dans la portée synchronized. Les appels à la même instance sont sérialisés même pour des clés différentes, et le nombre de requêtes attendant un chargeur lent n’est pas limité. Ce n’est donc pas une implémentation de cache de production à haute performance. Elle n’implémente ni single-flight par clé, ni limites d’appels source, ni délais, ni propagation d’invalidation entre réplicas évoqués ci-dessous. Les vérifications exécutées sont des scénarios séquentiels ; aucun test de charge concurrent n’a été effectué.
TTL et invalidation garantissent-ils des valeurs actuelles ?
Non. Cet exemple mesure le TTL à partir de la fin de la lecture source et du stockage de la valeur dans le cache. Si la source est elle-même un réplica de lecture retardé ou un ancien instantané, un TTL de 5 secondes ne signifie pas que la dernière valeur devient visible dans les 5 secondes suivant une modification de la source. La latence de lecture, le retard de réplication et la propagation de l’invalidation exigent un examen séparé.
Avec plusieurs réplicas utilisant un cache partagé, une course peut survenir même si vous mettez la base à jour puis supprimez l’entrée du cache. La lecture A commence à récupérer l’ancienne valeur ; l’écriture B valide une nouvelle valeur et supprime l’entrée ; puis A se termine tard et stocke à nouveau l’ancienne valeur. Le TTL réduit sa durée de présence mais n’élimine pas la course.
Les parcours exigeant l’état actuel doivent par exemple revalider dans la transaction source, ou empêcher les résultats tardifs d’écraser les plus récents avec des versions de données et des écritures conditionnelles. Si l’invalidation utilise des événements, traitez les pertes, les doublons et le délai entre commit et livraison. Si une modification touche plusieurs clés, comme listes, détails et agrégats, définissez aussi leur périmètre d’invalidation.
Distinguez expire-after-write et expire-after-access. Prolonger la validité à chaque accès peut conserver longtemps des valeurs périmées fréquemment lues. Pour revérifier une valeur après un délai fixe depuis son stockage, indépendamment du nombre de lectures, évaluez si l’expiration fondée sur l’écriture répond à votre objectif. Politiques d’expiration et d’éviction de Caffeine
Que se passe-t-il lors d’expirations simultanées ou d’une panne du cache ?
Si chaque requête lit la source au moment où une clé populaire expire, une ruée vers le cache peut survenir. Réduisez les lectures en double avec single-flight, qui regroupe les lectures d’une même clé en une opération en cours, et limitez aussi la concurrence et l’attente des appels source. Dédupliquer dans un processus ne signifie pas dédupliquer sur tous les réplicas. En Java, vous pouvez envisager des fonctions comme l’API atomique de recherche et de chargement de Caffeine, mais cela seul n’établit pas de limite de charge source à l’échelle du service.
Le jitter peut répartir les expirations lorsque les TTL de nombreuses clés se termineraient ensemble. Si la limite de fraîcheur est de 60 secondes, répartissez l’expiration dans une plage ne dépassant pas 60 secondes. Le jitter ne résout pas la concentration des requêtes sur une clé populaire. N’appliquez stale-while-revalidate, qui retourne une ancienne valeur pendant son actualisation, qu’aux parcours autorisant des réponses périmées, et fixez un âge maximal distinct si les actualisations continuent d’échouer.
Envoyer chaque requête à la base pendant une panne du cache est également risqué. À titre d’illustration, avec 10 000 RPS de lectures et un taux de succès normal de 90%, le trafic source est d’environ 1 000 RPS. La perte de tous les succès le porte à 10 000 RPS même avec une distribution identique des requêtes. C’est un exemple de calcul, pas une mesure, excluant nouvelles tentatives et appels d’actualisation.
Si la source ne supporte pas cette charge, limitez les requêtes de contournement, utilisez des copies locales approuvées ou des fonctionnalités réduites, ou refusez les requêtes excédentaires. Observez séparément les pannes de cache et les absences d’entrée, et limitez le rechargement massif à la reprise. Un bref cache négatif peut aider les parcours demandant sans cesse des identifiants inexistants, mais ne cachez pas un échec source comme « aucune donnée ». Définissez aussi son TTL et son invalidation pour rendre lisibles les nouvelles données.
Séparer caches HTTP et caches applicatifs
Les caches HTTP des navigateurs et CDN communiquent les politiques de réutilisation par les en-têtes de réponse. Ils constituent une couche distincte du TTL des objets stockés dans la JVM.
| Directive | Signification |
|---|---|
max-age=60 |
Indique que la réponse est fraîche tant que son âge est inférieur à 60 secondes |
s-maxage=60 |
Définit la durée de fraîcheur des caches partagés, en y remplaçant max-age et les paramètres associés |
private |
Restreint le stockage par les caches partagés ; les caches privés comme les navigateurs peuvent stocker |
no-cache |
Autorise le stockage mais exige une validation source réussie avant réutilisation |
no-store |
Demande aux caches de ne pas stocker cette requête ou réponse ; ce n’est pas une commande de suppression des copies existantes |
Si la langue est sélectionnée par Accept-Language, Vary et la configuration réelle du cache doivent refléter cette différence. Si l’URL sépare elle-même les langues, elle fait aussi partie de la clé. ETag et les requêtes conditionnelles peuvent réduire le volume transféré lorsque le contenu n’a pas changé, mais n’éliminent pas toujours le coût de validation source. private et no-store ne remplacent ni authentification, ni autorisation, ni chiffrement. RFC 9111 : mise en cache HTTP
Commencez les contrôles d’adoption par un parcours de lecture. Outre les succès normaux, vérifiez les limites de TTL, les lectures immédiatement après écriture, le même identifiant entre tenants et langues, la capacité maximale, les absences concurrentes, la panne du cache et la reprise. En production, suivez le nombre d’appels source, la latence, le taux d’échec, les chargements en cours, les évictions, l’usage mémoire et le délai d’invalidation en plus du taux de succès. Vous ne pouvez juger le bénéfice qu’après avoir vérifié si les réponses sont correctes et si la source survit sans le cache.
Discussion