Cache-Aside: Schlüssel, TTL, Invalidierung und Ausfälle verstehen
Auf dieser Seite
Caching verwendet bereits ermittelte Ergebnisse erneut, um Zugriffe auf die Datenquelle und Berechnungen zu reduzieren. Legen Sie für einen korrekten Einsatz zuerst fest, welche Anfragen ein Ergebnis teilen dürfen, wie lange die Wiederverwendung zulässig ist und wie das Ergebnis bei Änderungen der Quelle aktualisiert wird. Eine hohe Trefferquote macht einen Cache nicht korrekt, wenn er Daten eines anderen Benutzers liefert oder einen Kauf mit einem alten Preis abschließt.
Dieser Artikel richtet sich an Entwickler, die einen Cache für eine Lese-API erwägen. Er erklärt Cache-Aside anhand von Daten, die etwas Verzögerung vertragen, etwa Produktbeschreibungen, und führt TTL- und Kapazitätsgrenzen in Java aus. Operationen, die den aktuellen Zustand benötigen, etwa der Abschluss von Zahlung oder Bestand, sind von diesem Lesecache getrennt. Richtlinien für veraltete Daten bei Ausfällen knüpfen an den Artikel zum Fallback-Entwurf an.
Was sollte wo gecacht werden?
Beginnen Sie mit Pfaden, die wiederholte Lesezugriffe, teure Quellzugriffe und Spielraum für zeitlich begrenzt veraltete Antworten haben. Daten, die nur einmal verwendet werden oder sich fast vollständig je Benutzer unterscheiden, können mehr Speicherungs- und Invalidierungskosten verursachen, als Cache-Treffer einsparen.
| Ort | Reduzierbare Kosten | Zusätzlich festzulegende Bedingungen |
|---|---|---|
| HTTP-Cache im Browser oder CDN | Netzwerkrundreisen und Anfragen, die die API erreichen | Zulässigkeit gemeinsamer Nutzung, URL und Vary, Cache-Control |
| Anwendungslokaler Cache | Rundreisen zum entfernten Cache, DB-Lesezugriffe, wiederholte Berechnung | Speichergrenze je Prozess, Wertunterschiede zwischen Replikaten |
| Gemeinsamer Cache wie Redis | Wiederholte Quellzugriffe über Replikate hinweg | Netzwerklatenz, Fehlerverhalten, Serialisierung, Speicherkapazität |
Sie benötigen nicht sofort jede Ebene. Ein lokaler Cache ist schnell, doch jedes Replikat hält eine andere Kopie. Ein gemeinsamer Cache kann doppelte Speicherung reduzieren, fügt aber eine Netzwerk- und Betriebsabhängigkeit hinzu. Bei mehreren Ebenen muss auch die Invalidierung jede Ebene erreichen.
Wie funktioniert Cache-Aside?
Die Anwendung prüft zuerst den Cache. Fehlt der Eintrag oder ist er abgelaufen, liest sie aus der Quelle und speichert das Ergebnis im Cache. Dieser Ablauf heißt Cache-Aside. Schreibvorgänge committen üblicherweise zuerst die Quelländerung und invalidieren anschließend den zugehörigen Cache-Eintrag. Die Quelldaten überstehen den Cache-Verlust; das unterscheidet sich davon, den Cache selbst als einzige Aufzeichnung zu verwenden. Microsofts Erklärung zu Cache-Aside
Ein Cache-Schlüssel muss Eingaben enthalten, die das Ergebnis ändern. Beispielsweise repräsentiert Key(tenant, product, language) verschiedene Einträge für verschiedene Mandanten, Produkte und Sprachen. Ändern auch Währung, Benutzerberechtigungen oder Version des Darstellungsformats die Antwort, trennen Sie Schlüssel oder Cache-Geltungsbereich entsprechend. String-Verkettung ohne Trennzeichen kann Kollisionen verursachen; verwenden Sie daher strukturierte Schlüssel oder eine eindeutige Kodierung.
Eine Mandanten-ID im Schlüssel vervollständigt keine Autorisierung. Bestimmen Sie den Mandanten aus vertrauenswürdigem Authentifizierungskontext und prüfen Sie den Zugriff vor der Cache-Abfrage. Schreiben Sie Zugriffstokens oder Passwörter nicht direkt in Schlüssel oder Logs.
TTL ist die Dauer, für die ein Wert wiederverwendet werden darf; eine Kapazitätsgrenze bestimmt, wie viel gespeichert werden kann. Mit TTL allein können sich Einträge bis zu ihrem Ablauf weiter ansammeln. Mit nur einer Größenbegrenzung können veraltete Werte weiter Treffer erzeugen. Eintragsanzahl und tatsächliche Byte-Größe unterscheiden sich; berücksichtigen Sie bei großen Antworten Objekt- und serialisierte Größen.
Java-Beispiel: Schlüsseltrennung, Ablauf, Invalidierung und Kapazitätsgrenzen
Der folgende Code ist eine kleine Demonstration lokaler Cache-Semantik für Produktbeschreibungen je Mandant. Seine TTL von 5 Sekunden und höchstens 2 Einträge dienen der Verhaltensbeobachtung und sind keine Produktionsempfehlungen. Er nutzt die Zugriffsreihenfolge von LinkedHashMap, um den am längsten nicht verwendeten Eintrag zuerst zu verdrängen. Java-21-Dokumentation
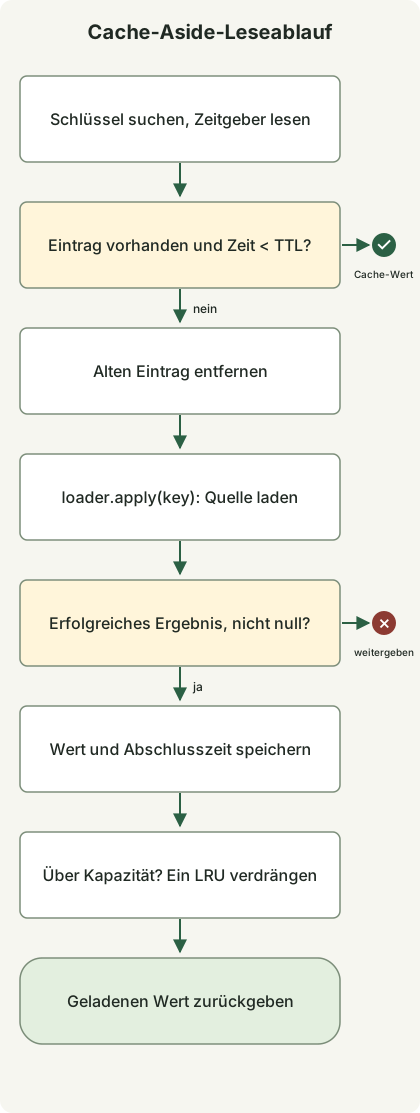
Das Diagramm zeigt get(). Scheitert der Quell-Loader, wird die Ausnahme weitergereicht und kein neuer Wert gespeichert. invalidate() ist eine separate Operation, die nach einer Quelländerung aufgerufen wird.
Speichern Sie dies als CacheDemo.java und führen Sie es mit JDK 21 oder neuer aus. Ein externer Server oder eine Bibliothek ist nicht erforderlich.
import java.time.Duration;
import java.util.LinkedHashMap;
import java.util.Objects;
import java.util.concurrent.atomic.AtomicInteger;
import java.util.concurrent.atomic.AtomicLong;
import java.util.function.Function;
import java.util.function.LongSupplier;

public class CacheDemo {
    record Key(String tenant, String product, String language) {}
    record Entry(String value, long loadedAt) {}

    static final class LocalCache {
        private final LinkedHashMap<Key, Entry> entries =
                new LinkedHashMap<>(16, 0.75f, true);
        private final LongSupplier ticker;
        private final long ttl = Duration.ofSeconds(5).toNanos();
        private final int maximumSize = 2;

        LocalCache(LongSupplier ticker) { this.ticker = ticker; }

        synchronized String get(Key key, Function<Key, String> loader) {
            Entry entry = entries.get(key);
            long now = ticker.getAsLong();
            if (entry != null && now - entry.loadedAt() < ttl) {
                return entry.value();
            }
            entries.remove(key);
            String value = Objects.requireNonNull(loader.apply(key));
            entries.put(key, new Entry(value, ticker.getAsLong()));
            if (entries.size() > maximumSize) {
                entries.remove(entries.keySet().iterator().next());
            }
            return value;
        }

        synchronized void invalidate(Key key) { entries.remove(key); }
    }

    static void expect(String actual, String expected) {
        if (!actual.equals(expected)) throw new AssertionError(actual);
        System.out.println(actual);
    }

    public static void main(String[] args) {
        AtomicLong clock = new AtomicLong();
        AtomicInteger loads = new AtomicInteger();
        LocalCache cache = new LocalCache(clock::get);
        Function<Key, String> loader = key ->
                key.tenant() + "/" + key.language() + "/v" + loads.incrementAndGet();
        Key ko = new Key("shop-a", "p1", "ko");
        Key en = new Key("shop-a", "p1", "en");
        Key other = new Key("shop-b", "p1", "ko");

        expect(cache.get(ko, loader), "shop-a/ko/v1");
        expect(cache.get(ko, loader), "shop-a/ko/v1");
        clock.set(Duration.ofSeconds(5).toNanos() - 1);
        expect(cache.get(ko, loader), "shop-a/ko/v1");
        clock.incrementAndGet();
        expect(cache.get(ko, loader), "shop-a/ko/v2");
        cache.invalidate(ko);
        expect(cache.get(ko, loader), "shop-a/ko/v3");
        expect(cache.get(en, loader), "shop-a/en/v4");
        expect(cache.get(ko, loader), "shop-a/ko/v3");
        expect(cache.get(other, loader), "shop-b/ko/v5");
        expect(cache.get(en, loader), "shop-a/en/v6");

        Key failing = new Key("shop-c", "p1", "ko");
        try {
            cache.get(failing, key -> { throw new IllegalStateException("origin"); });
            throw new AssertionError("Failure was swallowed");
        } catch (IllegalStateException expected) {
            expect(expected.getMessage(), "origin");
        }
        expect(cache.get(failing, loader), "shop-c/ko/v7");
    }
}
javac --release 21 CacheDemo.java
java CacheDemoDie folgende Ausgabe wurde mit Zulu JDK 21.0.1+12-LTS erzielt.
shop-a/ko/v1
shop-a/ko/v1
shop-a/ko/v1
shop-a/ko/v2
shop-a/ko/v3
shop-a/en/v4
shop-a/ko/v3
shop-b/ko/v5
shop-a/en/v6
origin
shop-c/ko/v7
Die ersten drei Zugriffe auf denselben Schlüssel lesen die Quelle nur einmal. Noch 1ns vor Ablauf wird derselbe Wert zurückgegeben; nach exakt 5 Sekunden wird er erneut geladen. Die folgenden Fälle prüfen explizite Invalidierung, Schlüsseltrennung nach Sprache und Mandant sowie Verdrängung nach Zugriffsreihenfolge. Sie enthalten auch einen erfolgreichen Zugriff nach einem Loader-Fehler. Werte wie v1 zeigen die Aufrufreihenfolge des Test-Loaders, keine tatsächlichen DB-Versionen.
Die Zeit wird mit einem manuell weitergestellten monotonen Zeitgeber statt durch Warten reproduziert. In einem echten Prozess können Sie mit new LocalCache(System::nanoTime) einen Zeitgeber für verstrichene Zeit bereitstellen. Das Beispiel behandelt abgelaufene Einträge beim Zugriff, statt sie sofort im Hintergrund zu entfernen. Es begrenzt die Eintragsanzahl, nicht Bytes.
Um den Code klein zu halten, läuft auch der Loader innerhalb des synchronized-Bereichs. Aufrufe derselben Instanz werden selbst für verschiedene Schlüssel serialisiert; die Anzahl der auf einen langsamen Loader wartenden Anfragen ist nicht begrenzt. Dies ist daher keine hochleistungsfähige Produktionscache-Implementierung. Sie implementiert weder schlüsselbezogenes Single-Flight noch Quellaufrufgrenzen, Timeouts oder Invalidierungsweitergabe zwischen Replikaten, die unten besprochen werden. Die Ausführungsprüfungen sind sequenzielle Szenarien; ein paralleler Lasttest wurde nicht durchgeführt.
Garantieren TTL und Invalidierung aktuelle Werte?
Nein. Dieses Beispiel misst TTL ab dem Abschluss des Quelllesens und der Speicherung des Werts im Cache. Ist die Quelle selbst ein verzögertes Lesereplikat oder ein alter Snapshot, bedeutet eine TTL von 5 Sekunden nicht, dass der neueste Wert innerhalb von 5 Sekunden nach einer Quelländerung sichtbar wird. Leselatenz, Replikationsverzögerung und Invalidierungsweitergabe müssen separat berücksichtigt werden.
Bei mehreren Replikaten mit gemeinsamem Cache kann selbst dann ein Rennen entstehen, wenn Sie die DB aktualisieren und anschließend den Cache-Eintrag löschen. Lesevorgang A beginnt, den alten Wert abzurufen; Schreibvorgang B committet einen neuen Wert und löscht den Cache-Eintrag; danach endet A verspätet und speichert den alten Wert erneut. TTL begrenzt dessen Verweildauer, beseitigt das Rennen aber nicht.
Pfade, die aktuellen Zustand benötigen, müssen beispielsweise innerhalb der Quelltransaktion erneut validieren oder mithilfe von Datenversionen und bedingten Schreibvorgängen verhindern, dass späte Ergebnisse neuere überschreiben. Erfolgt Invalidierung über Ereignisse, behandeln Sie Verlust, Duplikate und die Verzögerung zwischen Commit und Zustellung. Betrifft eine Änderung mehrere Schlüssel, etwa Listen, Details und Aggregate, definieren Sie auch deren Invalidierungsumfang.
Unterscheiden Sie expire-after-write von expire-after-access. Das Verlängern der Gültigkeit bei jedem Zugriff kann häufig gelesene veraltete Werte lange erhalten. Um einen Wert nach einer festen Zeit seit Speicherung unabhängig von der Leseanzahl neu zu prüfen, bewerten Sie, ob schreibbasierter Ablauf Ihr Ziel erfüllt. Caffeines Ablauf- und Verdrängungsrichtlinien
Was geschieht bei gleichzeitigem Ablauf oder Cache-Ausfall?
Wenn jede Anfrage im Moment des Ablaufs eines beliebten Schlüssels die Quelle liest, kann eine Cache-Stampede entstehen. Reduzieren Sie doppelte Lesezugriffe durch Single-Flight, das Zugriffe auf denselben Schlüssel zu einer laufenden Operation bündelt, und begrenzen Sie auch Parallelität und Wartezeit der Quellaufrufe. Deduplizierung innerhalb eines Prozesses bedeutet keine Deduplizierung über alle Replikate. In Java können Sie etwa Caffeines API für atomare Abfragen und Laden erwägen; allein damit entsteht jedoch keine dienstweite Lastgrenze der Quelle.
Jitter kann Ablaufzeiten verteilen, wenn die TTL vieler Schlüssel gleichzeitig enden würde. Beträgt die Aktualitätsgrenze 60 Sekunden, verteilen Sie den Ablauf innerhalb eines Bereichs, der 60 Sekunden nicht überschreitet. Jitter löst keine auf einen beliebten Schlüssel konzentrierten Anfragen. Wenden Sie stale-while-revalidate, das während der Aktualisierung einen alten Wert zurückgibt, nur auf Pfade an, die veraltete Antworten erlauben, und legen Sie bei fortgesetzten Aktualisierungsfehlern ein separates Höchstalter fest.
Auch jede Anfrage bei Cache-Ausfall an die DB zu senden ist riskant. Zur Veranschaulichung: Bei 10.000 RPS an Lesezugriffen und einer normalen Trefferquote von 90% beträgt der Quellverkehr etwa 1.000 RPS. Fallen alle Treffer aus, steigt er bei gleicher Anfrageverteilung auf 10.000 RPS. Dies ist ein Rechenbeispiel, keine Messung; Wiederholungen und Aktualisierungsaufrufe sind ausgeschlossen.
Kann die Quelle diese Last nicht tragen, begrenzen Sie Umgehungsanfragen, verwenden Sie freigegebene lokale Kopien oder reduzierte Funktionalität oder lehnen Sie überzählige Anfragen ab. Beobachten Sie Cache-Fehler getrennt von Cache-Misses und begrenzen Sie das Massenneuladen bei Wiederherstellung. Kurzes negatives Caching kann Pfaden helfen, die wiederholt nicht vorhandene IDs anfragen; speichern Sie jedoch keinen Quellfehler als „keine Daten“. Definieren Sie auch dafür TTL und Invalidierung, damit neu angelegte Daten lesbar werden.
HTTP-Caches von Anwendungscaches trennen
HTTP-Caches von Browsern und CDNs vermitteln Wiederverwendungsrichtlinien über Antwortheader. Sie sind eine separate Ebene gegenüber der TTL von Objekten innerhalb der JVM.
| Direktive | Bedeutung |
|---|---|
max-age=60 |
Gibt an, dass die Antwort frisch ist, solange ihr Alter unter 60 Sekunden liegt |
s-maxage=60 |
Legt die Frischelebensdauer gemeinsamer Caches fest und überschreibt dort max-age und verwandte Einstellungen |
private |
Beschränkt die Speicherung in gemeinsamen Caches; private Caches wie Browser dürfen speichern |
no-cache |
Erlaubt Speicherung, verlangt aber erfolgreiche Quellvalidierung vor der Wiederverwendung |
no-store |
Weist Caches an, diese Anfrage oder Antwort nicht zu speichern; es ist kein Befehl zum Löschen vorhandener Kopien |
Wird die Sprache über Accept-Language ausgewählt, müssen Vary und die tatsächliche Cache-Konfiguration diesen Unterschied berücksichtigen. Trennt die URL selbst Sprachen, ist auch diese URL Teil des Schlüssels. ETag und bedingte Anfragen können bei unverändertem Inhalt die Übertragungsmenge reduzieren, beseitigen aber nicht immer die Kosten der Quellvalidierung. private und no-store ersetzen weder Authentifizierung noch Autorisierung oder Verschlüsselung. RFC 9111: HTTP-Caching
Beginnen Sie die Einführungsprüfungen mit einem Lesepfad. Prüfen Sie neben normalen Treffern TTL-Grenzen, Zugriffe direkt nach Schreibvorgängen, dieselbe ID über Mandanten und Sprachen, Höchstkapazität, parallele Misses, Cache-Ausfall und Wiederherstellung. Erfassen Sie im Betrieb neben der Trefferquote Quellaufrufanzahl, Latenz, Fehlerrate, laufende Ladevorgänge, Verdrängungen, Speichernutzung und Invalidierungsverzögerung. Der Nutzen lässt sich erst beurteilen, nachdem geprüft wurde, ob Antworten korrekt sind und ob die Quelle ohne Cache überlebt.
Diskussion