Java Ponketmon: почему ответ равен min(разные типы, N/2)
Если из N элементов выбирают N/2, максимизируя число разных типов, ответ — min(distinct types, N/2). Нельзя выбрать больше типов, чем элементов, или придумать типы, которых нет во входе.
Задача Ponketmon задаёт положительное чётное N≤10 000 и идентификаторы типов от 1 до 200 000. Требуется одно максимальное количество, а не конкретная выборка.
Ход обработки
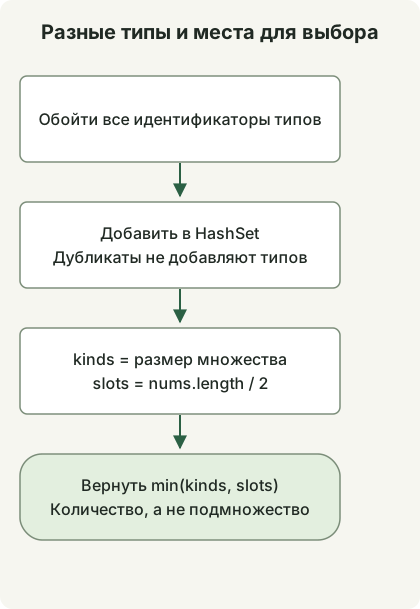
Число разных типов и ограничение выбора N/2 — верхние границы. При условиях задачи их минимум достижим.
Подсчёт типов через HashSet
Сохраните полный класс в Solution.java. Код исходной статьи скомпилирован для Java 11 и выполнен на JDK 17.
import java.util.HashSet;
import java.util.Set;

public class Solution {
    public int solution(int[] nums) {
        Set<Integer> kinds = new HashSet<>();
        for (int kind : nums) kinds.add(kind);
        return Math.min(kinds.size(), nums.length / 2);
    }
}
HashSet хранит каждый идентификатор один раз. Его размер — число разных типов u, а k=nums.length / 2 — число доступных мест выбора. Частоты отдельных типов здесь не нужны.
Доказательство достижимости границы
Если u≥k, выберите по одному элементу k разных типов. Если u<k, выберите по одному элементу каждого типа, затем заполните оставшиеся k-u мест другими элементами. Из N элементов использовано лишь u, а k≤N, поэтому остальных достаточно. Значит, верхняя граница min(u, k) достижима.
| Вход | Типы u | Места k | Ответ |
|---|---|---|---|
[3,1,2,3] |
3 | 2 | 2 |
[3,3,3,2,2,2] |
2 | 3 | 2 |
[7,7] |
1 | 1 | 1 |
При достаточно равномерных хешах ожидаемое время — O(N), дополнительная память — O(u). Для возврата выбранных индексов понадобилась бы отдельная процедура построения; этот метод вычисляет только требуемое количество.
На малых входах проверки сравнивают результат с перебором всех выборок N/2 позиций. Проверки максимальной длины охватывают 10 000 уникальных типов и 10 000 экземпляров одного типа. Они проверяют результат, не измеряя скорость реализации хеширования.
Для случая, где важно количество дубликатов, сравните частоты имён участника, не завершившего забег.
Обсуждение