Englische Ziffernwörter mit Java String.replace umwandeln
Bei gültigen Eingaben aus Ziffern und Ziffernwörtern werden die festen Wörter zero bis nine durch Ziffern ersetzt und das Ergebnis als Ganzzahl geparst. Die Suchbegriffe sind Literale; daher reicht String.replace ohne replaceAll aus.
Die Aufgabe garantiert gültige kleingeschriebene Ziffernwörter und Ziffern, ein Ergebnis von 1 bis 2.000.000.000 und keine führende Null. Dies ist kein Parser für allgemeine englische Zahlausdrücke.
Ablauf
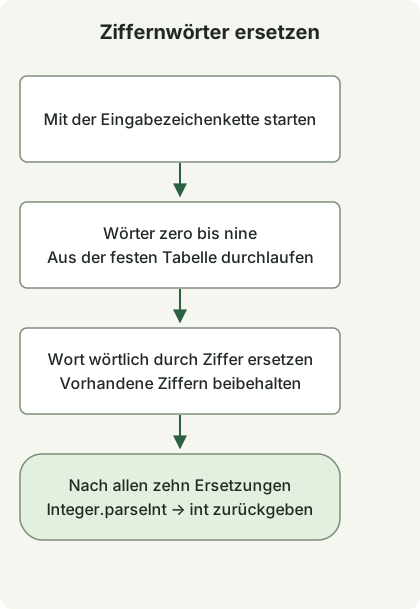
Die festen Wörter zero bis nine werden wörtlich durch Ziffern ersetzt; anschließend wird die entstandene Dezimalzeichenkette geparst.
Die zehn festen Wörter ersetzen
Speichern Sie die vollständige Klasse als Solution.java. Zusätzliche Imports sind unnötig; der Code des Ausgangsartikels wurde mit Java 11 als Ziel kompiliert und ausgeführt.
public class Solution {
    public int solution(String s) {
        String[] words = {"zero", "one", "two", "three", "four",
                "five", "six", "seven", "eight", "nine"};
        for (int digit = 0; digit < words.length; digit++) {
            s = s.replace(words[digit], Integer.toString(digit));
        }
        return Integer.parseInt(s);
    }
}
String.replace(CharSequence, CharSequence) ersetzt wörtlich. replaceAll interpretiert sein erstes Argument als regulären Ausdruck. Keines der zehn Wörter benötigt hier Regex-Syntax.
Zum Beispiel wird one4seveneight zu 1478 und 23four5six7 zu 234567. Eine reine Zifferneingabe wie 123 ergibt weiterhin 123. two mit neun folgenden zero-Wörtern ergibt 2.000.000.000 und liegt im int-Bereich.
Ersetzte Ziffern können kein neues Ziffernwort erzeugen, und keines der zehn Wörter enthält ein anderes Wort dieser Menge. Deshalb funktioniert diese Reihenfolge. Ungültige Wörter, Leerzeichen, Großbuchstaben und Zahlen außerhalb des Bereichs sind nicht durch die Aufgabe abgedeckt. Ein Parsefehler bei beliebigen Eingaben wird durch diese Methode nicht zu einer gültigen Ganzzahl repariert.
Bei zehn festen Wörtern beträgt die Laufzeit O(n) in der Eingabelänge. Zeichenketten sind unveränderlich; daher können Zwischenzeichenketten entstehen. Der zusätzliche Speicherbedarf ist O(n). Kein Benchmark belegt, dass diese Methode für die kleinen Eingaben schneller als andere Parser ist.
Vergleichen Sie die Normalisierung neuer IDs für eine Umformung, bei der reguläre Ausdrücke nützlich sind.
Diskussion