Rate-Limits mit Bucket4j: lokale Token-Buckets und verteilte Limits
Auf dieser Seite
Bucket4j ist eine Java-Bibliothek zur Anfragenbegrenzung, die Nachfüllung und Verbrauch eines Token-Buckets berechnet und Nebenläufigkeit steuert. Ein gemeinsam genutzter Bucket in Spring, aus dem jede Anfrage ein Token verbrauchen möchte, erlaubt separate Einstellungen für kurze Lastspitzen und die spätere Nachfüllrate. Lokale Buckets sind je JVM unabhängig; allein die Bibliothek erzeugt daher kein globales Limit über mehrere Server hinweg.
Der vorherige Artikel zur Begrenzung mit Redis Lua implementierte ein festes Zeitfenster, das ab der ersten erlaubten Anfrage zählt. Hier wird ein Token-Bucket in einer JVM mit Kapazität 5 und Nachfüllung von 5 Token über 10 Sekunden implementiert. Anschließend werden die veränderten Grenzen beim Übergang zu Redis im verteilten Modus erklärt.
Die Reproduktionsumgebung verwendet Bucket4j 8.22.0, Spring Boot 3.5.16, JDK 21 und Gradle 8.14.3. Die Bucket4j-Version wurde anhand der offiziellen Releases und der Referenz für 8.22.0 fixiert. jdk17 im Abhängigkeitsnamen bezeichnet ein Artefakt für die JDK-17-Familie; das Beispiel führt es mit JDK 21 aus.
Wie unterscheiden sich Kapazität und Nachfüllrate?
capacity(5) ist die Höchstzahl ansammelbarer Token. Standardmäßig sind auch anfangs fünf vorhanden, sodass zunächst fünf Anfragen gleichzeitig erlaubt werden können. refillGreedy(5, Duration.ofSeconds(10)) legt eine Rate von fünf Token pro zehn Sekunden fest. Verbraucht eine Anfrage ein Token, steht nach vollständigem Verbrauch bei t=0 bei t=2 seconds ein neues Token zur Verfügung.
Es wäre deshalb falsch, diese Richtlinie als „höchstens fünf Anfragen in beliebigen aufeinanderfolgenden zehn Sekunden“ zu beschreiben: Sie erlaubt sowohl den anfänglichen Burst von fünf als auch spätere Nachfüllungen. Selbst nach langer Inaktivität sammeln sich höchstens fünf Token an.
| Nachfüllmethode bei gleicher Kapazität und Menge | refillGreedy(5, 10 seconds) |
refillIntervally(5, 10 seconds) |
|---|---|---|
Alle fünf bei t=0 verbrauchen |
0 verbleiben | 0 verbleiben |
Ohne weiteren Verbrauch bei t=2 seconds prüfen |
1 verfügbar | 0 |
Ohne weiteren Verbrauch bei t=10 seconds prüfen |
5 | 5 |
Greedy füllt mit der Zeit schrittweise auf; Intervally füllt nach Ablauf der Periode gebündelt nach. Die Tabelle wurde mit einer bei null beginnenden kontrollierten Uhr geprüft. Ein separater Scheduler muss keine Token regelmäßig hinzufügen: Beim Prüfen oder Verbrauch des Buckets wird die vergangene Zeit in die Berechnung einbezogen. API-Details stehen in der Bucket4j-Referenz zur Nachfüllung.
Wie lassen sich Spring-MVC-Anfragen begrenzen?
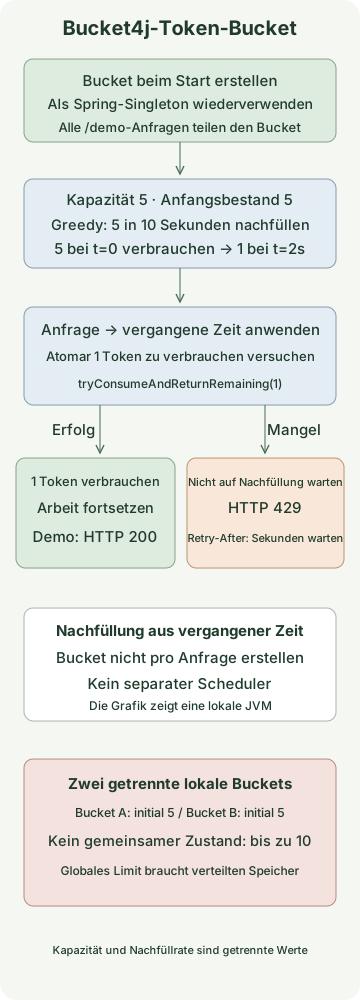
Der Controller nutzt das Ergebnis von tryConsumeAndReturnRemaining(1), statt den Tokenbestand getrennt abzufragen und die Zulassung zu schätzen. Ein ConsumptionProbe liefert Erfolg, verbleibende Token und bei Mangel die Wartezeit derselben Verbrauchsoperation.
Speichern Sie die folgenden fünf Dateien in einem Projekt. Alle /demo-Anfragen teilen einen Bucket. Nutzerbezogene Authentifizierung oder einen Bucket-Speicher implementiert das Beispiel nicht; der Server bindet nur an eine lokale Adresse.
settings.gradle
rootProject.name = 'bucket4j-token-bucket'build.gradle
plugins {
    id 'java'
    id 'application'
}
repositories { mavenCentral() }
java { toolchain { languageVersion = JavaLanguageVersion.of(21) } }
dependencies {
    implementation platform('org.springframework.boot:spring-boot-dependencies:3.5.16')
    implementation 'org.springframework.boot:spring-boot-starter-web'
    implementation 'com.bucket4j:bucket4j_jdk17-core:8.22.0'
    testImplementation 'org.springframework.boot:spring-boot-starter-test'
    testRuntimeOnly 'org.junit.platform:junit-platform-launcher'
}
application { mainClass = 'example.RateLimitApplication' }
test { useJUnitPlatform() }
src/main/resources/application.yml
server:
  address: 127.0.0.1
src/main/java/example/BucketPolicy.java
package example;

import java.time.Duration;
import io.github.bucket4j.Bucket;
import io.github.bucket4j.TimeMeter;

public final class BucketPolicy {
    private BucketPolicy() {}

    public static Bucket local(TimeMeter clock) {
        return Bucket.builder()
                .withCustomTimePrecision(clock)
                .addLimit(limit -> limit.capacity(5).refillGreedy(5, Duration.ofSeconds(10)))
                .build();
    }
}
src/main/java/example/RateLimitApplication.java
package example;

import io.github.bucket4j.Bucket;
import io.github.bucket4j.TimeMeter;
import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;
import org.springframework.context.annotation.Bean;
import org.springframework.http.ResponseEntity;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RestController;

@SpringBootApplication
public class RateLimitApplication {
    public static void main(String[] args) {
        SpringApplication.run(RateLimitApplication.class, args);
    }

    @Bean
    Bucket demoBucket() {
        return BucketPolicy.local(TimeMeter.SYSTEM_NANOTIME);
    }

    @RestController
    public static class DemoController {
        private final Bucket bucket;

        public DemoController(Bucket bucket) {
            this.bucket = bucket;
        }

        @GetMapping("/demo")
        public ResponseEntity<String> demo() {
            var probe = bucket.tryConsumeAndReturnRemaining(1);
            if (probe.isConsumed()) {
                return ResponseEntity.ok("ok\n");
            }
            long seconds = Math.max(1, Math.ceilDiv(probe.getNanosToWaitForRefill(), 1_000_000_000L));
            return ResponseEntity.status(429)
                    .header("Retry-After", Long.toString(seconds))
                    .body("rate limit exceeded\n");
        }
    }
}
Der Bucket ist ein standardmäßiges Spring-Singleton-Bean, damit der Zustand zwischen Anfragen erhalten bleibt. Würde Bucket.builder() bei jedem Aufruf in der Controller-Methode stehen, erhielte jede Anfrage erneut die anfänglichen Token. Eine vorhandene Prüfung würde dann kein echtes Limit durchsetzen.
Bei Tokenmangel liefert tryConsumeAndReturnRemaining eine Ablehnung, statt den Anfrage-Thread auf die Nachfüllung warten zu lassen. Dadurch wird nicht der gesamte MVC-Server nichtblockierend. Bei einer separaten wartenden API müssen Thread-Wartezeiten und Anfrage-Timeouts erneut betrachtet werden.
Welche Antworten sind zu erwarten?
Führen Sie das Beispiel mit JDK 21 und Gradle 8.14.3 aus, wenn Port 8080 frei ist. Ein Boot-Gradle-Plugin oder separater Redis-Server wird nicht benötigt. Beim ersten Lauf werden Maven-Central-Abhängigkeiten heruntergeladen.
gradle runRufen Sie nach Serverstart aus einem anderen Terminal auf. Voraussetzung sind ein neuer Bucket ohne andere Aufrufe und sechs Aufrufe, die vor der nächsten Token-Nachfüllung enden.
for attempt in 1 2 3 4 5 6; do
  curl -s -o /dev/null -w '%{http_code}\n' http://127.0.0.1:8080/demo
done
curl -i http://127.0.0.1:8080/demo
Die erwarteten Statuscodes folgen. Dauert die Ausführung länger oder kommen andere Anfragen hinzu, können Nachfüllung und Verbrauch das Ergebnis ändern.
200
200
200
200
200
429
Retry-After der abgelehnten Antwort ist getNanosToWaitForRefill() auf Sekunden aufgerundet, mindestens eine Sekunde. Mit kontrollierter Uhr war der Wert unmittelbar nach Verbrauch aller fünf Token 2 und nach 1,5 Sekunden 1. Wie in der Bedeutung von Retry-After bei HTTP 429 beschrieben, gibt er die Wartezeit vor einem erneuten Versuch an. Eine andere Anfrage kann das nächste Token zuerst verbrauchen; Warten reserviert daher keine spätere Zulassung.
Stoppen Sie den Beispielserver mit Ctrl+C im Terminal, in dem gradle run läuft.
Da das Token vor Arbeitsbeginn verbraucht wird, gibt dieser Code es bei späterem Fehlschlag nicht zurück. Ein Limit gestarteter Anfragen ist von einem Limit erfolgreicher Vorgänge zu unterscheiden.
Wie wurden parallele Anfragen und Zeitberechnung geprüft?
Die zehn Reproduktionstests verwenden echtes Bucket4j 8.22.0 und injizieren eine steuerbare Uhr in TimeMeter. Sie warten nicht mit Thread.sleep auf Zeitablauf. Auch der offizielle Intervally-Nachfülltest zeigt Zeitinjektion.
| Testbedingung | Beobachtetes Ergebnis |
|---|---|
| 40 Aufrufe von 8 Worker-Threads auf einen Bucket, Uhr fixiert | Genau 5 erlaubt |
| Kurz vor und genau 2 Sekunden nach Verbrauch von 5 | Kurz davor abgelehnt; 1 bei 2 Sekunden erlaubt |
| Lange vergangene Zeit | Kapazität 5 nie überschritten |
| Gleiche Uhr für Greedy und Intervally | Nachfüllunterschied entspricht der Tabelle oben |
| Zeit nach Ablehnung | Ablehnung verschiebt den Nachfüllbeginn nicht |
| Zwei unabhängige Buckets | Je 5, insgesamt 10 verbrauchbar |
| Bucket für jede Anfrage neu erstellen | 40 Anfragen in 40 neuen Buckets erlaubt; Umgehung reproduziert |
| Separater Bucket mit zwei Bandbreitenlimits | Verbrauch nur bei Erfüllung beider Limits |
Spring-MVC-MockMvc-Aufrufe |
200, 429 und Aufrundung der Wartezeit auf Sekunden geprüft |
Die MockMvc-Prüfung wurde von einer echten Netzwerkanfrage getrennt. Zusätzlich wurde die paketierte Anwendung auf eingebettetem Tomcat gestartet und eine echte HTTP-Antwort 200 geprüft. Die Zahl paralleler Aufrufe ist Eingabe einer Verhaltensprüfung, kein Durchsatz-Benchmark.
Wann Redis Lua oder Bucket4j wählen?
| Kriterium | Vorheriges Redis-Lua-Beispiel | Lokales Bucket4j-Beispiel hier |
|---|---|---|
| Richtlinie | Erlaubte Anfragen in einer mit der ersten Anfrage beginnenden Periode | Anfangsburst und spätere Nachfüllrate |
| Gemeinsamer Zustand | Anfragen mit demselben Redis und Schlüssel | Anfragen mit demselben Bucket-Objekt in einer JVM |
| Externer Speicheraufruf pro Anfrage | Redis-Ausführung nötig | Keiner |
| Wirkung weiterer Server | Gemeinsamer Zustand für denselben Schlüssel vorausgesetzt | Unabhängige Buckets erhöhen die Gesamtzulassung |
Dies behauptet nicht, Redis unterstütze nur feste Fenster oder Bucket4j nur den lokalen Modus. Verglichen werden Richtlinien und Speicherorte der beiden Artikel.
Für ein globales Limit ist die verteilte Speicherintegration von Bucket4j eine Option. Die Redis-Integration der Referenz 8.22.0 verwendet über Lettuce oder andere Clients einen ProxyManager und Bucket-Zustand unter einem gemeinsamen Schlüssel. Beim beschriebenen CAS-Verfahren liest und berechnet der Client den Zustand und vergleicht und ersetzt ihn in Redis; ein wegen Konkurrenz fehlgeschlagener Vergleich wird wiederholt. Das unterscheidet sich vom vorherigen Beispiel, das die gesamte Bucket-Berechnung in einer Redis-Lua-Ausführung durchführt.
Auch der Ablauf verteilter Zustände gehört zur Limitrichtlinie. Löscht eine kurze TTL einen Bucket, während Token fehlen, kann der nächste Zugriff einen neuen Bucket mit Anfangstoken erzeugen und zusätzliche Anfragen erlauben. Berücksichtigen Sie wie bei der offiziellen Ablaufstrategie die Zeit bis zur vollständigen Nachfüllung plus Reserve. Gegen erzwungene Verdrängung oder Datenverlust entsteht dadurch keine gleiche Garantie.
Das hier verwendete SYSTEM_NANOTIME ist für lokale Buckets vorgesehen. Verwenden Sie es nicht beliebig als verteilte Zeitreferenz über JVMs hinweg. Folgen Sie bei verteilter Implementierung der Zeitreferenz sowie den Timeout- und CAS-Retry-Einstellungen der Integration. Entscheiden Sie zusätzlich, ob Anfragen bei Redis-Ausfall gesperrt oder vorübergehend unter einer begrenzten lokalen Richtlinie erlaubt werden. Der Code hier führt weder Redis-Integration noch Failover aus.
Für Limits pro Nutzer leiten Sie den Bucket-Schlüssel vom authentifizierten Principal und dem Richtlinienumfang ab. Ein beliebiger Anfrage-Header als ungeprüfter Identifikator erlaubt Clients, das Limit durch Schlüsselwechsel zu umgehen. Fortlaufend neue Nutzer-Buckets in einer lokalen Map erhöhen den Speicherbedarf; unbedachte Verdrängung oder Neuerstellung kann wiederholt Anfangstoken gewähren. Legen Sie Speicherort und Aufbewahrungsdauer fest.
Ein Limit gestarteter Anfragen begrenzt nicht zugleich die Anzahl lang laufender Vorgänge, die Ressourcen parallel belegen. Geht es um Schutz von Datenbankverbindungen oder parallelen externen API-Aufrufen, ist zusätzlich ein separates Nebenläufigkeitslimit zu entwerfen.
Diskussion