Límites de solicitudes con Bucket4j: token bucket local y límites distribuidos
En esta página
Bucket4j es una biblioteca Java de límites de solicitudes que calcula la recarga y el consumo de un token bucket y controla la concurrencia. Compartir un bucket en Spring e intentar consumir un token por solicitud permite definir por separado la ráfaga permitida y la tasa posterior de recarga. Los buckets locales son independientes por JVM, por lo que añadir la biblioteca no crea por sí solo un límite global entre servidores.
El artículo anterior sobre límites con Redis Lua implementó una ventana fija que cuenta solicitudes durante un periodo iniciado con la primera solicitud permitida. Este artículo implementa un token bucket en una sola JVM con capacidad 5 y recarga de 5 tokens en 10 segundos y explica qué cambia al pasar al modo distribuido con Redis.
El entorno de reproducción es Bucket4j 8.22.0, Spring Boot 3.5.16, JDK 21 y Gradle 8.14.3. La versión de Bucket4j se fijó consultando las versiones oficiales y la referencia 8.22.0. jdk17 en el nombre de la dependencia indica un artefacto para la familia JDK 17; el ejemplo lo ejecuta en JDK 21.
¿En qué se diferencian la capacidad y la tasa de recarga?
capacity(5) es el máximo de tokens acumulables. El valor inicial predeterminado también es cinco, de modo que al principio pueden permitirse cinco solicitudes a la vez. refillGreedy(5, Duration.ofSeconds(10)) fija una tasa de cinco tokens cada diez segundos. Si cada solicitud consume un token, después de consumirlos todos en t=0, habrá un token nuevo disponible en t=2 seconds.
Por tanto, sería incorrecto describir esta política como «un máximo de cinco solicitudes en cualquier periodo consecutivo de diez segundos»: permite la ráfaga inicial de cinco y la recarga posterior. Incluso tras un largo periodo sin uso, el bucket no acumula más de su capacidad de cinco.
| Método de recarga con igual capacidad y cantidad | refillGreedy(5, 10 seconds) |
refillIntervally(5, 10 seconds) |
|---|---|---|
Consumir los cinco en t=0 |
Quedan 0 | Quedan 0 |
Consultar en t=2 seconds sin consumo adicional |
1 disponible | 0 |
Consultar en t=10 seconds sin consumo adicional |
5 | 5 |
Greedy recarga gradualmente con el tiempo; Intervally recarga en bloque al terminar el periodo. La tabla se comprobó con un reloj controlado que empieza en cero. No hace falta un planificador que añada tokens periódicamente: el tiempo transcurrido se refleja al consultar o consumir el bucket. Consulta la referencia de recarga de Bucket4j para los detalles de la API.
¿Cómo limitar solicitudes de Spring MVC?
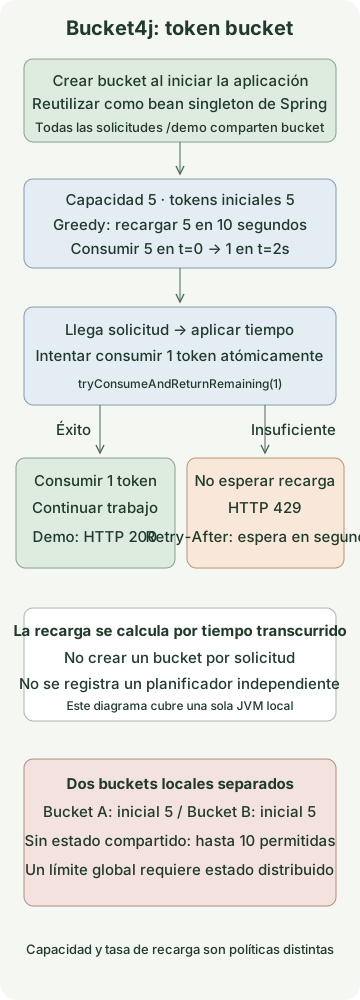
El controlador usa el resultado de tryConsumeAndReturnRemaining(1) en lugar de consultar el número de tokens por separado y deducir si permite la solicitud. Un ConsumptionProbe devuelve el éxito, los tokens restantes y, si no hay suficientes, el tiempo de espera correspondiente al mismo intento de consumo.
Guarda los cinco archivos siguientes en un proyecto. Todas las solicitudes /demo comparten un bucket. El ejemplo no implementa autenticación por usuario ni almacenamiento de buckets, y el servidor solo escucha en una dirección local.
settings.gradle
rootProject.name = 'bucket4j-token-bucket'build.gradle
plugins {
    id 'java'
    id 'application'
}
repositories { mavenCentral() }
java { toolchain { languageVersion = JavaLanguageVersion.of(21) } }
dependencies {
    implementation platform('org.springframework.boot:spring-boot-dependencies:3.5.16')
    implementation 'org.springframework.boot:spring-boot-starter-web'
    implementation 'com.bucket4j:bucket4j_jdk17-core:8.22.0'
    testImplementation 'org.springframework.boot:spring-boot-starter-test'
    testRuntimeOnly 'org.junit.platform:junit-platform-launcher'
}
application { mainClass = 'example.RateLimitApplication' }
test { useJUnitPlatform() }
src/main/resources/application.yml
server:
  address: 127.0.0.1
src/main/java/example/BucketPolicy.java
package example;

import java.time.Duration;
import io.github.bucket4j.Bucket;
import io.github.bucket4j.TimeMeter;

public final class BucketPolicy {
    private BucketPolicy() {}

    public static Bucket local(TimeMeter clock) {
        return Bucket.builder()
                .withCustomTimePrecision(clock)
                .addLimit(limit -> limit.capacity(5).refillGreedy(5, Duration.ofSeconds(10)))
                .build();
    }
}
src/main/java/example/RateLimitApplication.java
package example;

import io.github.bucket4j.Bucket;
import io.github.bucket4j.TimeMeter;
import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;
import org.springframework.context.annotation.Bean;
import org.springframework.http.ResponseEntity;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RestController;

@SpringBootApplication
public class RateLimitApplication {
    public static void main(String[] args) {
        SpringApplication.run(RateLimitApplication.class, args);
    }

    @Bean
    Bucket demoBucket() {
        return BucketPolicy.local(TimeMeter.SYSTEM_NANOTIME);
    }

    @RestController
    public static class DemoController {
        private final Bucket bucket;

        public DemoController(Bucket bucket) {
            this.bucket = bucket;
        }

        @GetMapping("/demo")
        public ResponseEntity<String> demo() {
            var probe = bucket.tryConsumeAndReturnRemaining(1);
            if (probe.isConsumed()) {
                return ResponseEntity.ok("ok\n");
            }
            long seconds = Math.max(1, Math.ceilDiv(probe.getNanosToWaitForRefill(), 1_000_000_000L));
            return ResponseEntity.status(429)
                    .header("Retry-After", Long.toString(seconds))
                    .body("rate limit exceeded\n");
        }
    }
}
El Bucket es un bean singleton predeterminado de Spring para conservar su estado entre solicitudes. Si se llama a Bucket.builder() dentro del controlador cada vez, se crean tokens iniciales para cada solicitud. Aunque exista una comprobación, no se aplicaría un límite real.
Si no hay suficientes tokens, tryConsumeAndReturnRemaining devuelve un rechazo en lugar de hacer que el hilo de la solicitud espere la recarga. Esto no convierte todo el servidor MVC en no bloqueante. Elegir otra API que espere obliga a reconsiderar la espera de hilos y el tiempo límite de las solicitudes.
¿Qué respuestas se esperan?
Ejecuta el ejemplo con JDK 21 y Gradle 8.14.3 instalados y el puerto 8080 libre. No se necesitan el plugin de Gradle de Boot ni un servidor Redis separado. La primera ejecución descarga dependencias de Maven Central.
gradle runCuando el servidor esté listo, llama desde otra terminal. Se supone un bucket nuevo sin otras llamadas y que las seis llamadas terminan antes de la siguiente recarga.
for attempt in 1 2 3 4 5 6; do
  curl -s -o /dev/null -w '%{http_code}\n' http://127.0.0.1:8080/demo
done
curl -i http://127.0.0.1:8080/demo
Los códigos de estado esperados aparecen a continuación. Si tarda más o intervienen otras solicitudes, la recarga y el consumo pueden cambiar el resultado.
200
200
200
200
200
429
El Retry-After del rechazo es getNanosToWaitForRefill() redondeado hacia arriba a segundos, con un mínimo de un segundo. Con un reloj controlado fue 2 justo después de consumir los cinco tokens y 1 después de 1.5 segundos. Como indica la semántica de Retry-After de HTTP 429, comunica al cliente cuánto debe esperar antes de reintentar. Otra solicitud puede consumir antes el siguiente token, así que esperar no reserva una autorización posterior.
Detén el servidor con Ctrl+C en la terminal que ejecuta gradle run.
Como el token se consume antes de comenzar el trabajo, este código no lo devuelve si el trabajo falla después. Distingue un límite de solicitudes iniciadas de uno de operaciones exitosas.
¿Cómo se comprobaron la concurrencia y el tiempo?
Las diez pruebas de reproducción usan Bucket4j 8.22.0 real e inyectan un reloj controlable en TimeMeter. No usan Thread.sleep para esperar. La prueba oficial de recarga Intervally también muestra la inyección de tiempo.
| Condición de prueba | Resultado observado |
|---|---|
| 40 llamadas desde 8 hilos a un bucket con reloj fijo | Exactamente 5 permitidas |
| Justo antes y exactamente 2 segundos después de consumir 5 | Rechazo antes; 1 permitida a los 2 segundos |
| Mucho tiempo transcurrido | No supera la capacidad 5 |
| Mismo reloj para Greedy e Intervally | La diferencia coincide con la tabla anterior |
| Pasa tiempo tras un rechazo | El rechazo no retrasa el inicio de la recarga |
| Dos buckets independientes | Se pueden consumir 5 en cada uno, 10 en total |
| Crear un bucket por solicitud | 40 solicitudes permitidas con 40 buckets nuevos, reproduciendo la evasión |
| Bucket separado con dos límites de ancho de banda | Ambos límites deben cumplirse para consumir |
Llamadas de Spring MVC MockMvc |
Se verifican 200, 429 y el redondeo del tiempo de espera a segundos |
La prueba MockMvc se distingue de una solicitud de red real. Por separado se inició la aplicación empaquetada en Tomcat integrado y se verificó una respuesta HTTP 200 real. El número de llamadas concurrentes es una entrada de verificación funcional, no una medición de rendimiento.
¿Cuándo elegir Redis Lua o Bucket4j?
| Criterio | Ejemplo anterior con Redis Lua | Ejemplo local de Bucket4j |
|---|---|---|
| Política | Solicitudes permitidas durante un periodo iniciado con la primera solicitud | Ráfaga inicial y tasa posterior de recarga |
| Estado compartido | Solicitudes con el mismo Redis y clave | Solicitudes con el mismo objeto bucket en una JVM |
| Llamada a almacenamiento externo por solicitud | Necesita ejecución en Redis | Ninguna |
| Efecto de añadir servidores | Supone estado compartido para la misma clave | Los buckets independientes aumentan el total permitido |
No se afirma que Redis solo permita ventanas fijas ni que Bucket4j solo funcione localmente. Se comparan las políticas y ubicaciones de estado implementadas en ambos artículos.
Para un límite global, considera la integración de Bucket4j con almacenamiento distribuido. La referencia 8.22.0 para Redis usa ProxyManager y estado de bucket bajo una clave común mediante Lettuce u otro cliente. En el método CAS descrito, el cliente lee y calcula el estado y después compara y reemplaza en Redis; si la comparación falla por contención, reintenta. Esto difiere del ejemplo anterior, que realiza todo el cálculo en una sola ejecución Lua en Redis.
La caducidad del estado distribuido también forma parte de la política. Si un TTL corto elimina un bucket con tokens insuficientes, el siguiente acceso puede crear otro con tokens iniciales y permitir solicitudes adicionales. Como en la estrategia oficial de caducidad, considera el tiempo de recarga completa más un margen. Eso no garantiza lo mismo ante expulsión forzada o pérdida de datos.
El SYSTEM_NANOTIME utilizado aquí es para buckets locales. No lo uses arbitrariamente como referencia temporal distribuida entre JVM. En una implementación distribuida sigue la referencia de tiempo, los tiempos límite y los reintentos CAS de esa integración. Decide también si bloquear solicitudes cuando Redis falle o permitirlas temporalmente con una política local limitada. El código de este artículo no ejecuta integración Redis ni recuperación ante fallos.
Para límites por usuario, deriva la clave del bucket del principal autenticado y del alcance de la política. Confiar ciegamente en un identificador arbitrario de cabecera permite evadir el límite cambiándolo. Añadir buckets por usuario continuamente a un Map local aumenta la memoria y una expulsión o recreación descuidada puede conceder tokens iniciales repetidamente. Decide dónde y durante cuánto tiempo se conserva el estado.
Limitar el inicio de solicitudes tampoco limita la cantidad de operaciones largas que ocupan recursos simultáneamente. Si quieres proteger conexiones a bases de datos o llamadas simultáneas a API externas, diseña también un límite de concurrencia independiente.
Comentarios