Limiter les requêtes avec Bucket4j : seaux locaux et limites distribuées
Sur cette page
Bucket4j est une bibliothèque Java de limitation des requêtes qui calcule le remplissage et la consommation d’un seau à jetons et contrôle la concurrence. Partager un seau dans Spring et tenter de consommer un jeton par requête permet de régler séparément la rafale initiale et le rythme de remplissage. Les seaux locaux étant indépendants par JVM, ajouter la bibliothèque ne crée pas à lui seul une limite globale entre serveurs.
L’article précédent sur Redis Lua implémentait une fenêtre fixe comptant les requêtes pendant une période commençant à la première autorisation. Ici nous implémentons un seau dans une seule JVM, de capacité 5 et remplissant 5 jetons en 10 secondes, puis expliquons les limites modifiées par le passage au mode distribué Redis.
L’environnement de reproduction utilise Bucket4j 8.22.0, Spring Boot 3.5.16, JDK 21 et Gradle 8.14.3. La version Bucket4j a été fixée d’après les versions officielles et la référence 8.22.0. jdk17 dans le nom de dépendance désigne un artefact pour la famille JDK 17 ; l’exemple l’exécute avec JDK 21.
Quelle différence entre capacité et rythme de remplissage ?
capacity(5) est le nombre maximal de jetons accumulables. Le nombre initial par défaut est aussi cinq : cinq requêtes peuvent donc être autorisées immédiatement au départ. refillGreedy(5, Duration.ofSeconds(10)) définit un rythme de cinq jetons en dix secondes. Si une requête consomme un jeton, après consommation totale à t=0, un nouveau jeton est disponible à t=2 seconds.
Il serait donc incorrect de décrire cette politique comme « au plus cinq requêtes pendant n’importe quelles dix secondes consécutives » : elle permet la rafale initiale de cinq puis les remplissages suivants. Même après une longue inactivité, le seau n’accumule pas plus que sa capacité de cinq.
| Méthode pour une capacité et une quantité identiques | refillGreedy(5, 10 seconds) |
refillIntervally(5, 10 seconds) |
|---|---|---|
Consommer les cinq à t=0 |
0 restant | 0 restant |
Vérifier à t=2 seconds sans autre consommation |
1 disponible | 0 |
Vérifier à t=10 seconds sans autre consommation |
5 | 5 |
Greedy remplit progressivement avec le temps ; Intervally remplit en bloc à la fin de la période. Le tableau a été vérifié avec une horloge contrôlée commençant à zéro. Aucun ordonnanceur séparé n’a besoin d’ajouter périodiquement des jetons : le temps écoulé est intégré au calcul lors d’une consultation ou d’une consommation. Voir la référence Bucket4j sur le remplissage pour l’API.
Comment limiter les requêtes Spring MVC ?
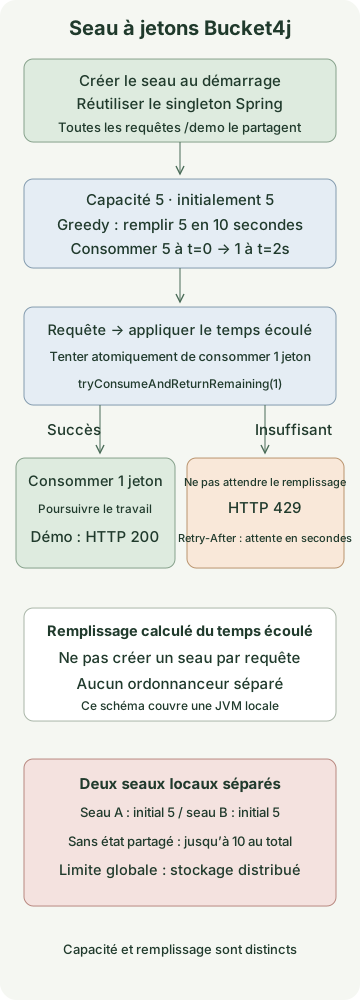
Le contrôleur utilise le résultat de tryConsumeAndReturnRemaining(1) au lieu de consulter séparément le nombre de jetons puis d’estimer l’autorisation. Un ConsumptionProbe fournit le succès, les jetons restants et, en cas de manque, l’attente pour cette même tentative.
Enregistrez les cinq fichiers suivants dans un même projet. Toutes les requêtes /demo partagent un seau. L’exemple n’implémente ni authentification par utilisateur ni stockage de seaux, et le serveur n’écoute qu’une adresse locale.
settings.gradle
rootProject.name = 'bucket4j-token-bucket'build.gradle
plugins {
    id 'java'
    id 'application'
}
repositories { mavenCentral() }
java { toolchain { languageVersion = JavaLanguageVersion.of(21) } }
dependencies {
    implementation platform('org.springframework.boot:spring-boot-dependencies:3.5.16')
    implementation 'org.springframework.boot:spring-boot-starter-web'
    implementation 'com.bucket4j:bucket4j_jdk17-core:8.22.0'
    testImplementation 'org.springframework.boot:spring-boot-starter-test'
    testRuntimeOnly 'org.junit.platform:junit-platform-launcher'
}
application { mainClass = 'example.RateLimitApplication' }
test { useJUnitPlatform() }
src/main/resources/application.yml
server:
  address: 127.0.0.1
src/main/java/example/BucketPolicy.java
package example;

import java.time.Duration;
import io.github.bucket4j.Bucket;
import io.github.bucket4j.TimeMeter;

public final class BucketPolicy {
    private BucketPolicy() {}

    public static Bucket local(TimeMeter clock) {
        return Bucket.builder()
                .withCustomTimePrecision(clock)
                .addLimit(limit -> limit.capacity(5).refillGreedy(5, Duration.ofSeconds(10)))
                .build();
    }
}
src/main/java/example/RateLimitApplication.java
package example;

import io.github.bucket4j.Bucket;
import io.github.bucket4j.TimeMeter;
import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;
import org.springframework.context.annotation.Bean;
import org.springframework.http.ResponseEntity;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RestController;

@SpringBootApplication
public class RateLimitApplication {
    public static void main(String[] args) {
        SpringApplication.run(RateLimitApplication.class, args);
    }

    @Bean
    Bucket demoBucket() {
        return BucketPolicy.local(TimeMeter.SYSTEM_NANOTIME);
    }

    @RestController
    public static class DemoController {
        private final Bucket bucket;

        public DemoController(Bucket bucket) {
            this.bucket = bucket;
        }

        @GetMapping("/demo")
        public ResponseEntity<String> demo() {
            var probe = bucket.tryConsumeAndReturnRemaining(1);
            if (probe.isConsumed()) {
                return ResponseEntity.ok("ok\n");
            }
            long seconds = Math.max(1, Math.ceilDiv(probe.getNanosToWaitForRefill(), 1_000_000_000L));
            return ResponseEntity.status(429)
                    .header("Retry-After", Long.toString(seconds))
                    .body("rate limit exceeded\n");
        }
    }
}
Le Bucket est un bean singleton Spring par défaut pour conserver son état entre les requêtes. Appeler Bucket.builder() dans la méthode du contrôleur à chaque requête recréerait les jetons initiaux à chaque fois. La présence d’une vérification n’imposerait alors aucune vraie limite.
En cas de manque, tryConsumeAndReturnRemaining renvoie un refus sans faire attendre le thread de requête jusqu’au remplissage. Cela ne rend pas tout le serveur MVC non bloquant. Le choix d’une API d’attente distincte impose de revoir l’attente des threads et les délais des requêtes.
Quelles réponses attendre ?
Exécutez l’exemple avec JDK 21 et Gradle 8.14.3 installés et le port 8080 libre. Le plugin Boot Gradle et un serveur Redis séparé ne sont pas nécessaires. Les dépendances Maven Central sont téléchargées au premier lancement.
gradle runUne fois le serveur prêt, appelez-le depuis un autre terminal. On suppose un nouveau seau sans autre appel et six appels terminés avant le prochain remplissage d’un jeton.
for attempt in 1 2 3 4 5 6; do
  curl -s -o /dev/null -w '%{http_code}\n' http://127.0.0.1:8080/demo
done
curl -i http://127.0.0.1:8080/demo
Les codes d’état attendus suivent. Si l’exécution dure plus longtemps ou si d’autres requêtes interviennent, remplissage et consommation peuvent modifier le résultat.
200
200
200
200
200
429
Le Retry-After de la réponse refusée est getNanosToWaitForRefill() arrondi à la seconde supérieure, avec un minimum d’une seconde. Avec une horloge contrôlée, il valait 2 immédiatement après consommation des cinq jetons et 1 après 1,5 seconde. Selon la sémantique Retry-After de HTTP 429, il indique le délai avant un nouvel essai. Une autre requête peut consommer le jeton suivant ; attendre ne réserve donc pas une autorisation future.
Arrêtez le serveur d’exemple avec Ctrl+C dans le terminal exécutant gradle run.
Le jeton étant consommé avant le travail, ce code ne le restitue pas si le travail échoue ensuite. Il faut distinguer une limite de requêtes démarrées d’une limite d’opérations réussies.
Comment vérifier concurrence et calcul du temps ?
Les dix tests de reproduction utilisent Bucket4j 8.22.0 réel et injectent une horloge contrôlable dans TimeMeter. Ils n’utilisent pas Thread.sleep pour attendre. Le test officiel de remplissage Intervally montre aussi l’injection du temps.
| Condition du test | Résultat observé |
|---|---|
| 40 appels de 8 threads vers un seau, horloge figée | Exactement 5 autorisés |
| Juste avant et exactement 2 secondes après consommation de 5 | Refus juste avant ; 1 autorisé à 2 secondes |
| Long temps écoulé | La capacité 5 n’est jamais dépassée |
| Même horloge pour Greedy et Intervally | Différence conforme au tableau précédent |
| Temps écoulé après un refus | Le refus ne repousse pas le début du remplissage |
| Deux seaux indépendants | 5 chacun, 10 au total consommables |
| Recréer le seau à chaque requête | 40 requêtes autorisées par 40 nouveaux seaux : contournement reproduit |
| Seau séparé avec deux limites de bande passante | Les deux limites doivent être respectées pour consommer |
Appels Spring MVC MockMvc |
200, 429 et arrondi de l’attente en secondes vérifiés |
La vérification MockMvc est distincte d’une vraie requête réseau. Séparément, l’application empaquetée a été démarrée sur Tomcat embarqué et une vraie réponse HTTP 200 a été vérifiée. Le nombre d’appels concurrents est une entrée de test de comportement, pas un benchmark de débit.
Quand choisir Redis Lua ou Bucket4j ?
| Critère | Exemple Redis Lua précédent | Exemple Bucket4j local ici |
|---|---|---|
| Politique | Requêtes autorisées pendant une période commençant à la première requête | Rafale initiale et rythme de remplissage suivant |
| État partagé | Requêtes utilisant le même Redis et la même clé | Requêtes utilisant le même objet seau dans une JVM |
| Appel au stockage externe par requête | Exécution Redis nécessaire | Aucun |
| Effet d’ajouter des serveurs | Suppose un état partagé pour la même clé | Les seaux indépendants augmentent l’autorisation totale |
Cela n’affirme pas que Redis ne prend en charge que les fenêtres fixes ou Bucket4j que le mode local. La comparaison porte sur les politiques et lieux de stockage implémentés dans ces deux articles.
Pour une limite globale, envisagez l’intégration de stockage distribué de Bucket4j. La référence 8.22.0 sur Redis utilise un ProxyManager et l’état du seau sous une clé commune via Lettuce ou un autre client. Dans l’approche CAS décrite, le client lit et calcule l’état puis le compare et le remplace dans Redis ; une comparaison échouée sous concurrence est réessayée. Ce chemin diffère de l’exemple précédent, qui exécute tout le calcul du seau en une exécution Redis Lua.
L’expiration de l’état distribué fait aussi partie de la politique. Si une durée TTL courte supprime un seau alors que les jetons manquent, le prochain accès peut créer un nouveau seau avec des jetons initiaux et autoriser des requêtes supplémentaires. Comme dans la stratégie officielle d’expiration, tenez compte du temps nécessaire au remplissage complet plus une marge. Cela ne donne pas la même garantie en cas d’éviction forcée ou de perte de données.
Le SYSTEM_NANOTIME utilisé ici concerne les seaux locaux. Ne l’utilisez pas arbitrairement comme référence temporelle distribuée entre JVM. Pour une implémentation distribuée, suivez la référence temporelle et les réglages de délai et de reprise CAS de l’intégration. Décidez séparément de bloquer les requêtes lors d’un échec Redis ou de les autoriser temporairement avec une politique locale bornée. Ce code n’exécute ni intégration Redis ni bascule.
Pour des limites par utilisateur, dérivez la clé du seau de l’identité authentifiée et du périmètre de la politique. Faire confiance sans vérification à un identifiant arbitraire d’en-tête permet aux clients d’échapper à la limite en changeant de clé. Ajouter continuellement des seaux utilisateur à une Map locale augmente la mémoire ; une éviction ou recréation irréfléchie peut accorder plusieurs fois les jetons initiaux. Décidez où et combien de temps conserver l’état.
Limiter les débuts de requête ne limite pas aussi le nombre d’opérations longues occupant des ressources simultanément. Si l’objectif est de protéger les connexions à la base ou les appels API externes concurrents, concevez aussi une limite de concurrence distincte.
Discussion