Rust einsetzen: eine CLI zur zeilenweisen Zugriffslog-Aggregation
Auf dieser Seite
Eine CLI zur Dateiverarbeitung mit klaren Ein- und Ausgaben ist ein guter Einstieg, um Rust praktisch zu nutzen. Dieser Artikel liest ein Log zeilenweise und zählt Anfragen nach HTTP-Statuscode. Entscheidend ist, nicht die gesamte Datei als String zu halten und ungültige Datensätze von Lesefehlern zu unterscheiden.
Wir wenden Ownership, Borrowing und Result aus der vorherigen Rust-Einführung auf Datei-I/O an. Das Beispiel wurde mit Rust 1.100.0, Edition 2024, unter macOS arm64 ausgeführt und verwendet nur die Standardbibliothek. Externe Pakete oder Netzwerkverbindungen sind nicht erforderlich. Falls die Werkzeuge noch fehlen, beginnen Sie mit der offiziellen Installationsanleitung.
Für welche Aufgaben eignet sich Rust?
Wiederholt ausgeführte Werkzeuge zur Dateikonvertierung, Validierung und Aggregation sind geeignet, Rusts Ressourcenverwaltung und Fehlerbehandlung zu lernen. Bei der Verteilung von Binärdateien im Team müssen Zielbetriebssystem, CPU und benötigte Systembibliotheken zusammenpassen. Ein auf einem Rechner erstelltes Programm läuft nicht automatisch in jeder Umgebung.
Eine einmalige Analyse kann mit einer vertrauten Shell oder Python schneller erledigt sein. Statt den Durchsatz zu vermuten, sollten Sie den wiederkehrenden Wartungsbedarf und die Lernkosten des Teams abwägen. Dieser Artikel überprüft den Ablauf und das Fehlerverhalten, vergleicht aber weder Geschwindigkeit noch Speichernutzung mit anderen Sprachen.
Logformat und Fehlerpolitik festlegen
Das Beispiel liest ein vereinfachtes Zugriffslog mit den zwei Feldern status-code path. Es ist kein Parser für das Standardformat von Nginx oder Apache. Die Eingabe gilt als reguläre, fertig geschriebene Datei; Rotation, Live-Verfolgung und Dekompression sind nicht enthalten.
| Bedingung | Behandlung |
|---|---|
Zwei durch Leerraum getrennte Felder, dreistelliger ASCII-Status 100–599 und Pfad mit / am Anfang |
valid und den Zähler dieses Status erhöhen |
| Leere Zeile oder ungültige Feldzahl, Status oder Pfad | invalid erhöhen und mit der nächsten Zeile fortfahren |
| Dateiöffnungs- oder Lesefehler, ungültiges UTF-8 oder Zeile länger als 4096 Byte | Analyse abbrechen, ohne Gesamtergebnis mit Exit-Code 2 beenden |
EOF erreicht, invalid ist 0 |
Ergebnis ausgeben und mit Code 0 beenden |
EOF erreicht, invalid ist mindestens 1 |
Ergebnis ausgeben und mit Code 1 beenden |
Leerraum umfasst auch mehrere Leerzeichen und Tabulatoren. Das Zeilenlimit zählt Zeilenendbytes wie LF oder CRLF mit; die letzte Zeile benötigt keinen Zeilenumbruch. Eine leere Datei ist mit valid=0 invalid=0 ein erfolgreiches Ergebnis. Der Pfad dient nur zur Formatprüfung und wird nicht im Ergebnis gespeichert.
Ein Ausgabefehler ergibt ebenfalls Exit-Code 2. Vor Abschluss der Analyse werden keine Ergebnisse ausgegeben. Fällt das Ausgabegerät während des Schreibens aus, können jedoch bereits Teile der Ausgabe geschrieben sein. Prüfen Sie daher den Exit-Code, bevor Sie das Ergebnis verwenden.
Projekt vorbereiten
Die folgenden Befehle und Beispiele verwenden eine macOS- oder Linux-Shell. Unter macOS sind zusätzlich die Command Line Tools für das native Linken nötig.
rustup toolchain install 1.100.0 --profile minimal --component rustfmt --component clippy
cargo +1.100.0 new access-summary --bin --edition 2024
cd access-summary
mkdir -p examples tests
Speichern Sie die folgenden Dateien. Cargo bindet src/lib.rs als Bibliothek und src/main.rs als ausführbares Programm ein. So lassen sich Dateiöffnung und Bildschirmausgabe getrennt von der Aggregationslogik prüfen.
Cargo.toml
[package]
name = "access-summary"
version = "0.1.0"
edition = "2024"

[dependencies]
rust-toolchain.toml
[toolchain]
channel = "1.100.0"
profile = "minimal"
components = ["rustfmt", "clippy"]
examples/access.log
200 /api/orders
503 /api/orders
200 /health
404 /missing
broken-line
700 /outside-range
Mit BufReader und BTreeMap aggregieren
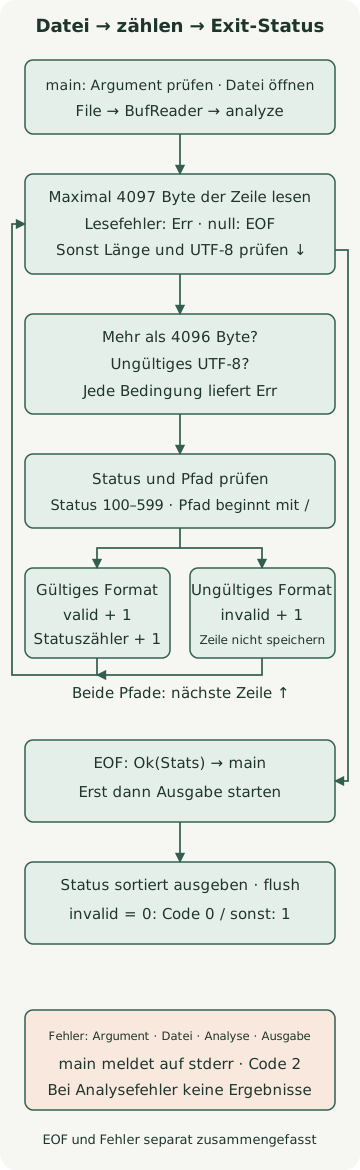
Der Schleifenpfad zeigt das Lesen der nächsten Zeile nach der Verarbeitung. Rechts verbindet eine Linie EOF mit der Rückgabe der Ergebnisse. Argument-, Datei-, Analyse- und Ausgabefehler sind unten zusammengefasst; der Code reicht sie mit ? an main weiter.
src/lib.rs
use std::{
    collections::BTreeMap,
    io::{self, BufRead, Read},
    str,
};

pub const MAX_LINE_BYTES: usize = 4096;

#[derive(Default, Debug, PartialEq, Eq)]
pub struct Stats {
    pub valid: u64,
    pub invalid: u64,
    pub by_status: BTreeMap<u16, u64>,
}

fn parse_status(line: &str) -> Option<u16> {
    let mut fields = line.split_whitespace();
    let code = fields.next()?;
    let path = fields.next()?;
    if fields.next().is_some() || !path.starts_with('/') {
        return None;
    }
    if code.len() != 3 || !code.bytes().all(|byte| byte.is_ascii_digit()) {
        return None;
    }
    let status = code.parse::<u16>().ok()?;
    (100..=599).contains(&status).then_some(status)
}

pub fn analyze<R: BufRead>(mut reader: R) -> io::Result<Stats> {
    let mut stats = Stats::default();
    let mut buffer = Vec::new();
    loop {
        buffer.clear();
        let read = reader
            .by_ref()
            .take((MAX_LINE_BYTES + 1) as u64)
            .read_until(b'\n', &mut buffer)?;
        if read == 0 {
            return Ok(stats);
        }
        if buffer.len() > MAX_LINE_BYTES {
            return Err(io::Error::new(
                io::ErrorKind::InvalidData,
                "line exceeds 4096 bytes",
            ));
        }
        let line = str::from_utf8(&buffer)
            .map_err(|_| io::Error::new(io::ErrorKind::InvalidData, "input is not UTF-8"))?;
        match parse_status(line) {
            Some(status) => {
                stats.valid += 1;
                *stats.by_status.entry(status).or_default() += 1;
            }
            None => stats.invalid += 1,
        }
    }
}
BufReader puffert kleine Leseanfragen. analyze<R: BufRead> verlangt gepuffertes Leseverhalten statt eines konkreten Dateityps; Tests können daher einen Cursor im Speicher oder eine fehlschlagende Eingabe einsetzen. Der generische Typ bedeutet keine asynchrone oder parallele Verarbeitung.
Zeilenweises Lesen setzt für sich kein Größenlimit. read_until hängt Daten bis zum Trennzeichen oder EOF an einen Puffer an und kann sehr lange Zeilen lesen. Daher verbraucht das Beispiel mittels Read::take höchstens 4097 Byte pro Iteration und prüft anschließend das Limit von 4096 Byte. take begrenzt Bytes, nicht die Lesezeit.
buffer.clear() leert die Pufferlänge für die nächste Zeile und nutzt die Allokation erneut. Der Aggregationsvektor hält die aktuelle Zeile; BufReader kann weitere Bytes vorgelesen haben. Lesepuffer, Vektorallokation und Map benötigen jeweils Speicher. Da es höchstens 500 Statuscodes gibt, erhöht eine größere Zahl von URLs nicht die Zahl der Map-Schlüssel. Dies ist keine Messung des tatsächlichen Prozessspeichers.
parse_status leiht den String als &str, prüft ihn und gibt nur den Statuscode zurück. BTreeMap durchläuft Schlüssel sortiert und eignet sich daher zur aufsteigenden Ausgabe. entry(...).or_default() beginnt einen fehlenden Statuszähler bei null.
Ausgabe und Exit-Codes in main festlegen
src/main.rs
use access_summary::analyze;
use std::{
    env,
    fs::File,
    io::{self, BufReader, Write},
    process::ExitCode,
};

fn run() -> io::Result<u8> {
    let mut args = env::args_os().skip(1);
    let path = args
        .next()
        .filter(|_| args.next().is_none())
        .ok_or_else(|| {
            io::Error::new(io::ErrorKind::InvalidInput, "usage: access-summary <file>")
        })?;
    let stats = analyze(BufReader::new(File::open(path)?))?;
    let mut out = io::BufWriter::new(io::stdout().lock());
    writeln!(out, "valid={} invalid={}", stats.valid, stats.invalid)?;
    for (status, count) in &stats.by_status {
        writeln!(out, "status={status} count={count}")?;
    }
    out.flush()?;
    Ok(if stats.invalid == 0 { 0 } else { 1 })
}

fn main() -> ExitCode {
    match run() {
        Ok(code) => ExitCode::from(code),
        Err(error) => {
            let _ = writeln!(io::stderr().lock(), "error: {error}");
            ExitCode::from(2)
        }
    }
}
args_os übernimmt den Dateipfad als Betriebssystem-String. Das io::Result<Stats> der Analyse ist mit io::Result<u8> von run verbunden; Dateiöffnungs- und Analysefehler gelangen so in den Fehlerzweig von main. Auch BufWriter puffert die Ausgabe; flush()? prüft Schreibfehler bei verbleibender Ausgabe. Scheitert sogar die Ausgabe der Diagnose auf stderr, wird dieser Schreibfehler ignoriert und Exit-Code 2 beibehalten.
invalid zählt lesbare Datensätze, die die Regeln nicht erfüllen. Eine vorhandene Ausgabe bedeutet daher nicht, dass jede Eingabe gültig war. Code 1 bedeutet, dass die Analyse mit mindestens einem ungültigen Datensatz abgeschlossen wurde; sind alle Zeilen ungültig, kann valid 0 sein. Code 2 bedeutet einen Ausführungsfehler. Die Tests und separaten CLI-Läufe unten prüfen diesen Unterschied.
Beispiel ausführen und Ergebnis prüfen
cargo check --offline
cargo fmt --check
cargo clippy --offline --all-targets -- -D warnings
cargo build --offline --release
./target/release/access-summary examples/access.log
echo $?
Das Beispiel enthält vier gültige und zwei ungültige Zeilen. Die tatsächliche Ausgabe folgt. Die letzte 1 ist der mit echo $? ermittelte Exit-Code und gehört nicht zur Aggregation.
valid=4 invalid=2
status=200 count=2
status=404 count=1
status=503 count=1
1| Zusätzliche Eingabe oder Ausführungsbedingung | Standardausgabe | Exit-Code |
|---|---|---|
| Datei nur mit gültigen Zeilen | Gesamtes Ergebnis | 0 |
| Leere Datei | valid=0 invalid=0 |
0 |
| Eine leere Zeile | valid=0 invalid=1 |
1 |
| Fehlendes Dateiargument, zwei Argumente oder nicht existierende Datei | Keine; Grund auf stderr | 2 |
| Ungültiges UTF-8 nach einer gültigen Zeile | Keine; Grund auf stderr | 2 |
| Eine 4097 Byte lange Zeile | Keine; Grund auf stderr | 2 |
Grenzwerte und Fehler ohne Dateien testen
Cursor lässt Bytes im Speicher wie eine Eingabe lesen. Ohne Abhängigkeit von Datenträger oder Netzwerk injiziert ein separater Typ außerdem einen Lesefehler, der mit einer echten Datei umständlich zu erzeugen wäre. Speichern Sie die folgende Datei und führen Sie den Befehl aus.
cargo test --offlinetests/stream.rs
use access_summary::{MAX_LINE_BYTES, analyze};
use std::io::{self, BufRead, Cursor, Read};

#[test]
fn counts_valid_and_invalid_lines_in_status_order() {
    let stats = analyze(Cursor::new(include_bytes!("../examples/access.log"))).unwrap();
    assert_eq!((stats.valid, stats.invalid), (4, 2));
    assert_eq!(
        stats.by_status.into_iter().collect::<Vec<_>>(),
        vec![(200, 2), (404, 1), (503, 1)]
    );
}

#[test]
fn accepts_crlf_and_a_final_line_without_newline() {
    let stats = analyze(Cursor::new(b"200 /a\r\n503 /b")).unwrap();
    assert_eq!((stats.valid, stats.invalid), (2, 0));
}

#[test]
fn empty_file_and_blank_line_are_different() {
    assert_eq!(analyze(Cursor::new(b"")).unwrap().invalid, 0);
    assert_eq!(analyze(Cursor::new(b"\n")).unwrap().invalid, 1);
}

#[test]
fn rejects_malformed_status_and_fields_as_invalid_records() {
    let data = "099 /a\n600 /a\n+20 /a\n200 /a\n200 relative\n200 /a extra\n200\n";
    let stats = analyze(Cursor::new(data.as_bytes())).unwrap();
    assert_eq!((stats.valid, stats.invalid), (0, 7));
}

#[test]
fn invalid_utf8_aborts_instead_of_reporting_partial_statistics() {
    let error = analyze(Cursor::new(b"200 /a\n\xff\n")).unwrap_err();
    assert_eq!(error.kind(), io::ErrorKind::InvalidData);
    assert_eq!(error.to_string(), "input is not UTF-8");
}

#[test]
fn accepts_exact_byte_limit_including_newline() {
    let mut data = b"200 /".to_vec();
    data.resize(MAX_LINE_BYTES - 1, b'a');
    data.push(b'\n');
    assert_eq!(analyze(Cursor::new(data)).unwrap().valid, 1);
}

#[test]
fn stops_consuming_an_oversized_line_after_limit_plus_one() {
    let mut reader = Cursor::new(vec![b'x'; 100_000]);
    let error = analyze(&mut reader).unwrap_err();
    assert_eq!(error.to_string(), "line exceeds 4096 bytes");
    assert_eq!(reader.position(), (MAX_LINE_BYTES + 1) as u64);
}

struct FailingReader;
impl Read for FailingReader {
    fn read(&mut self, _: &mut [u8]) -> io::Result<usize> {
        Err(io::Error::other("injected read failure"))
    }
}
impl BufRead for FailingReader {
    fn fill_buf(&mut self) -> io::Result<&[u8]> {
        Err(io::Error::other("injected read failure"))
    }
    fn consume(&mut self, _: usize) {}
}

#[test]
fn propagates_reader_failure() {
    assert_eq!(
        analyze(FailingReader).unwrap_err().to_string(),
        "injected read failure"
    );
}
Alle acht ausgeführten Tests waren erfolgreich. Separate CLI-Prüfungen verglichen Ausgabe und Exit-Code jeweils im Debug- und Release-Modus und überprüften die Anzahl für 100.000 identische gültige Zeilen. Diese Eingabe prüfte die Aggregationsgenauigkeit; sie war kein Lasttest und garantiert weder Durchsatz, maximale Dateigröße noch Speichernutzung.
Für ein Betriebswerkzeug wählen Sie zuerst einen Parser für das tatsächliche Logformat und beginnen mit vollständig geschriebenen Dateien. Aggregation nach URL oder Live-Erfassung erfordert eine eigene Gestaltung von Schlüsselzahl, Aufbewahrung, Dateirotation und doppelter Zählung nach Neustart. Eine bloße Erweiterung der Statuszählung dieses Beispiels löst diese Aufgaben nicht.
Diskussion