Utiliser Rust : créer une CLI qui agrège un journal ligne par ligne
Sur cette page
Une CLI de traitement de fichiers aux entrées et résultats clairs est un bon point de départ pour utiliser Rust en pratique. Cet article lit un journal ligne par ligne et compte les requêtes par code HTTP. L’essentiel est de ne pas conserver le fichier entier dans une chaîne et de distinguer les enregistrements invalides des échecs de lecture.
Nous appliquons la propriété, l’emprunt et Result de la précédente introduction à Rust aux E/S de fichiers. L’exemple a été exécuté avec Rust 1.100.0, édition 2024, sur macOS arm64 et utilise uniquement la bibliothèque standard. Aucun paquet externe ni accès réseau n’est nécessaire. Si les outils manquent, commencez par les instructions officielles d’installation.
Pour quelles tâches utiliser Rust ?
Les outils de conversion, de validation et d’agrégation de fichiers exécutés régulièrement permettent d’apprendre la gestion des ressources et des erreurs en Rust. Pour distribuer des binaires à une équipe, le système cible, le processeur et les bibliothèques système requises doivent correspondre. Un exécutable compilé sur une machine ne fonctionne pas dans tous les environnements.
Une analyse ponctuelle peut être plus rapide avec un shell familier ou Python. Au lieu de supposer un débit, pesez le besoin d’entretien répété de l’outil et le coût d’apprentissage de l’équipe. Cet article vérifie le flux et les échecs ; il ne compare ni la vitesse ni la mémoire utilisée avec d’autres langages.
Définir le format et les règles d’échec
L’exemple lit un journal d’accès simplifié à deux champs, status-code path. Ce n’est pas un analyseur des journaux Nginx ou Apache par défaut. L’entrée est supposée être un fichier ordinaire dont l’écriture est terminée ; rotation, suivi en direct et décompression sont hors périmètre.
| Condition | Traitement |
|---|---|
Deux champs séparés par des espaces, statut ASCII à trois chiffres entre 100 et 599 et chemin commençant par / |
Incrémenter valid et le compteur du statut |
| Ligne vide ou nombre de champs, statut ou chemin invalide | Incrémenter invalid, puis lire la ligne suivante |
| Échec d’ouverture ou de lecture, UTF-8 invalide ou ligne de plus de 4096 octets | Échec de l’analyse, code de sortie 2 sans afficher les totaux |
EOF atteint avec invalid égal à 0 |
Afficher les totaux et sortir avec le code 0 |
EOF atteint avec invalid supérieur ou égal à 1 |
Afficher les totaux et sortir avec le code 1 |
La séparation par espaces inclut plusieurs espaces consécutifs et les tabulations. La limite inclut les octets de fin de ligne comme LF ou CRLF ; la dernière ligne peut ne pas finir par un saut de ligne. Un fichier vide est un résultat réussi avec valid=0 invalid=0. Le chemin sert uniquement à vérifier le format et n’est pas conservé dans les totaux.
Un échec d’écriture produit également le code 2. Aucun total n’est affiché avant la fin de l’analyse, mais une panne du périphérique pendant l’écriture peut laisser une sortie partielle déjà écrite. Vérifiez donc le code de sortie avant d’utiliser le résultat.
Préparer le projet
Les commandes et les exemples utilisent un shell macOS ou Linux. Sur macOS, installez aussi les Command Line Tools nécessaires à l’édition de liens native.
rustup toolchain install 1.100.0 --profile minimal --component rustfmt --component clippy
cargo +1.100.0 new access-summary --bin --edition 2024
cd access-summary
mkdir -p examples tests
Enregistrez les fichiers ci-dessous. Cargo utilise src/lib.rs comme bibliothèque et src/main.rs comme programme exécutable. Cette séparation permet de vérifier l’ouverture du fichier et l’affichage indépendamment de la logique d’agrégation.
Cargo.toml
[package]
name = "access-summary"
version = "0.1.0"
edition = "2024"

[dependencies]
rust-toolchain.toml
[toolchain]
channel = "1.100.0"
profile = "minimal"
components = ["rustfmt", "clippy"]
examples/access.log
200 /api/orders
503 /api/orders
200 /health
404 /missing
broken-line
700 /outside-range
Agréger avec BufReader et BTreeMap
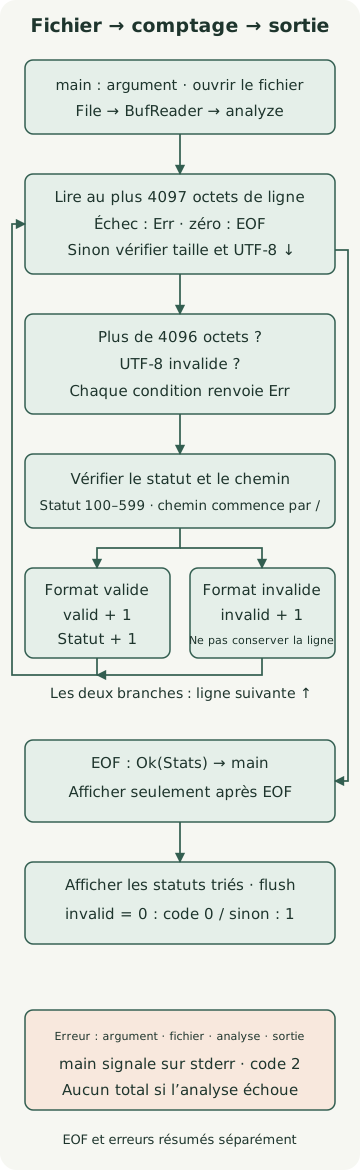
La boucle représente la lecture de la ligne suivante après traitement. À droite, le chemin EOF rejoint le retour des totaux. Les erreurs d’argument, de fichier, d’analyse et de sortie sont résumées dans le bloc inférieur ; le code les transmet à main avec ?.
src/lib.rs
use std::{
    collections::BTreeMap,
    io::{self, BufRead, Read},
    str,
};

pub const MAX_LINE_BYTES: usize = 4096;

#[derive(Default, Debug, PartialEq, Eq)]
pub struct Stats {
    pub valid: u64,
    pub invalid: u64,
    pub by_status: BTreeMap<u16, u64>,
}

fn parse_status(line: &str) -> Option<u16> {
    let mut fields = line.split_whitespace();
    let code = fields.next()?;
    let path = fields.next()?;
    if fields.next().is_some() || !path.starts_with('/') {
        return None;
    }
    if code.len() != 3 || !code.bytes().all(|byte| byte.is_ascii_digit()) {
        return None;
    }
    let status = code.parse::<u16>().ok()?;
    (100..=599).contains(&status).then_some(status)
}

pub fn analyze<R: BufRead>(mut reader: R) -> io::Result<Stats> {
    let mut stats = Stats::default();
    let mut buffer = Vec::new();
    loop {
        buffer.clear();
        let read = reader
            .by_ref()
            .take((MAX_LINE_BYTES + 1) as u64)
            .read_until(b'\n', &mut buffer)?;
        if read == 0 {
            return Ok(stats);
        }
        if buffer.len() > MAX_LINE_BYTES {
            return Err(io::Error::new(
                io::ErrorKind::InvalidData,
                "line exceeds 4096 bytes",
            ));
        }
        let line = str::from_utf8(&buffer)
            .map_err(|_| io::Error::new(io::ErrorKind::InvalidData, "input is not UTF-8"))?;
        match parse_status(line) {
            Some(status) => {
                stats.valid += 1;
                *stats.by_status.entry(status).or_default() += 1;
            }
            None => stats.invalid += 1,
        }
    }
}
BufReader met en tampon les petites lectures. analyze<R: BufRead> demande un comportement de lecture tamponnée plutôt qu’un type de fichier concret : les tests peuvent le remplacer par un Cursor en mémoire ou une entrée qui échoue. Le type générique ne signifie pas que le traitement est asynchrone ou parallèle.
Lire ligne par ligne ne crée pas automatiquement de limite de taille. read_until ajoute au tampon jusqu’au séparateur ou à EOF et peut lire de très longues lignes. L’exemple utilise donc Read::take pour consommer au plus 4097 octets par itération, puis vérifie le dépassement de 4096 octets. take limite les octets, pas la durée de lecture.
buffer.clear() vide la longueur du tampon pour la ligne suivante et réutilise l’allocation. Le vecteur d’agrégation contient la ligne courante et BufReader peut avoir lu des octets en avance. Le tampon de lecture, l’allocation du vecteur et la map d’agrégation nécessitent chacun de la mémoire. Les statuts étant limités à 500 types au maximum, davantage d’URL n’augmente pas le nombre de clés de la map. Ce n’est pas une mesure de la mémoire réelle du processus.
parse_status emprunte la chaîne comme &str, la vérifie et ne renvoie que le statut. BTreeMap parcourt les clés dans l’ordre et permet donc d’afficher les statuts par ordre croissant. entry(...).or_default() initialise à zéro un compteur absent.
Déterminer sortie et codes dans main
src/main.rs
use access_summary::analyze;
use std::{
    env,
    fs::File,
    io::{self, BufReader, Write},
    process::ExitCode,
};

fn run() -> io::Result<u8> {
    let mut args = env::args_os().skip(1);
    let path = args
        .next()
        .filter(|_| args.next().is_none())
        .ok_or_else(|| {
            io::Error::new(io::ErrorKind::InvalidInput, "usage: access-summary <file>")
        })?;
    let stats = analyze(BufReader::new(File::open(path)?))?;
    let mut out = io::BufWriter::new(io::stdout().lock());
    writeln!(out, "valid={} invalid={}", stats.valid, stats.invalid)?;
    for (status, count) in &stats.by_status {
        writeln!(out, "status={status} count={count}")?;
    }
    out.flush()?;
    Ok(if stats.invalid == 0 { 0 } else { 1 })
}

fn main() -> ExitCode {
    match run() {
        Ok(code) => ExitCode::from(code),
        Err(error) => {
            let _ = writeln!(io::stderr().lock(), "error: {error}");
            ExitCode::from(2)
        }
    }
}
args_os reçoit le chemin sous forme de chaîne du système d’exploitation. Le io::Result<Stats> de l’analyse est relié au io::Result<u8> de run ; les échecs d’ouverture ou d’analyse peuvent ainsi atteindre la branche d’erreur de main. BufWriter met aussi la sortie en tampon et flush()? vérifie l’échec d’écriture du reste. Si l’écriture du diagnostic sur stderr échoue elle-même, cette erreur d’écriture est ignorée et le code 2 est conservé.
invalid compte les enregistrements lisibles qui ne respectent pas les règles. Une sortie ne prouve donc pas que toutes les entrées étaient valides. Le code 1 indique une analyse terminée avec au moins un enregistrement invalide ; si toutes les lignes sont invalides, valid peut valoir 0. Le code 2 indique un échec d’exécution. Les tests et les exécutions CLI séparées ci-dessous vérifient cette distinction.
Exécuter l’exemple et vérifier le résultat
cargo check --offline
cargo fmt --check
cargo clippy --offline --all-targets -- -D warnings
cargo build --offline --release
./target/release/access-summary examples/access.log
echo $?
L’exemple contient quatre lignes valides et deux invalides. Voici la sortie réelle. Le dernier 1 est le code de sortie observé avec echo $?, pas une partie des totaux.
valid=4 invalid=2
status=200 count=2
status=404 count=1
status=503 count=1
1| Entrée ou condition supplémentaire | Sortie standard | Code de sortie |
|---|---|---|
| Fichier avec seulement des lignes valides | Totaux complets | 0 |
| Fichier vide | valid=0 invalid=0 |
0 |
| Une ligne vide | valid=0 invalid=1 |
1 |
| Argument de fichier absent, deux arguments ou fichier inexistant | Aucune ; raison sur stderr | 2 |
| UTF-8 invalide après une ligne valide | Aucune ; raison sur stderr | 2 |
| Ligne de 4097 octets | Aucune ; raison sur stderr | 2 |
Tester limites et échecs sans fichier
Cursor permet de lire des octets en mémoire comme une entrée. Sans dépendre du disque ni du réseau, un type séparé injecte aussi un échec de lecture difficile à produire avec un vrai fichier. Enregistrez le fichier ci-dessous et exécutez la commande.
cargo test --offlinetests/stream.rs
use access_summary::{MAX_LINE_BYTES, analyze};
use std::io::{self, BufRead, Cursor, Read};

#[test]
fn counts_valid_and_invalid_lines_in_status_order() {
    let stats = analyze(Cursor::new(include_bytes!("../examples/access.log"))).unwrap();
    assert_eq!((stats.valid, stats.invalid), (4, 2));
    assert_eq!(
        stats.by_status.into_iter().collect::<Vec<_>>(),
        vec![(200, 2), (404, 1), (503, 1)]
    );
}

#[test]
fn accepts_crlf_and_a_final_line_without_newline() {
    let stats = analyze(Cursor::new(b"200 /a\r\n503 /b")).unwrap();
    assert_eq!((stats.valid, stats.invalid), (2, 0));
}

#[test]
fn empty_file_and_blank_line_are_different() {
    assert_eq!(analyze(Cursor::new(b"")).unwrap().invalid, 0);
    assert_eq!(analyze(Cursor::new(b"\n")).unwrap().invalid, 1);
}

#[test]
fn rejects_malformed_status_and_fields_as_invalid_records() {
    let data = "099 /a\n600 /a\n+20 /a\n200 /a\n200 relative\n200 /a extra\n200\n";
    let stats = analyze(Cursor::new(data.as_bytes())).unwrap();
    assert_eq!((stats.valid, stats.invalid), (0, 7));
}

#[test]
fn invalid_utf8_aborts_instead_of_reporting_partial_statistics() {
    let error = analyze(Cursor::new(b"200 /a\n\xff\n")).unwrap_err();
    assert_eq!(error.kind(), io::ErrorKind::InvalidData);
    assert_eq!(error.to_string(), "input is not UTF-8");
}

#[test]
fn accepts_exact_byte_limit_including_newline() {
    let mut data = b"200 /".to_vec();
    data.resize(MAX_LINE_BYTES - 1, b'a');
    data.push(b'\n');
    assert_eq!(analyze(Cursor::new(data)).unwrap().valid, 1);
}

#[test]
fn stops_consuming_an_oversized_line_after_limit_plus_one() {
    let mut reader = Cursor::new(vec![b'x'; 100_000]);
    let error = analyze(&mut reader).unwrap_err();
    assert_eq!(error.to_string(), "line exceeds 4096 bytes");
    assert_eq!(reader.position(), (MAX_LINE_BYTES + 1) as u64);
}

struct FailingReader;
impl Read for FailingReader {
    fn read(&mut self, _: &mut [u8]) -> io::Result<usize> {
        Err(io::Error::other("injected read failure"))
    }
}
impl BufRead for FailingReader {
    fn fill_buf(&mut self) -> io::Result<&[u8]> {
        Err(io::Error::other("injected read failure"))
    }
    fn consume(&mut self, _: usize) {}
}

#[test]
fn propagates_reader_failure() {
    assert_eq!(
        analyze(FailingReader).unwrap_err().to_string(),
        "injected read failure"
    );
}
Les huit tests exécutés ont réussi. Des vérifications CLI séparées ont comparé sorties et codes de sortie en modes debug et release et contrôlé le nombre de 100 000 lignes valides identiques. Cette entrée vérifiait la justesse de l’agrégation ; ce n’était pas un test de charge garantissant débit, taille maximale de fichier ou mémoire utilisée.
Pour en faire un outil d’exploitation, choisissez d’abord un analyseur adapté au vrai format et commencez par traiter les fichiers dont l’écriture est terminée. L’agrégation par URL ou la collecte en direct exigent de concevoir séparément le nombre de clés, la rétention, la rotation et le double comptage après redémarrage. Étendre le seul compteur de statuts de cet exemple ne résout pas ces questions.
Discussion