Применение Rust: CLI для подсчёта HTTP-статусов в журнале
На этой странице
CLI для обработки файлов с понятными входными данными и результатами — хороший способ начать применять Rust на практике. В этой статье программа читает журнал построчно и подсчитывает запросы по HTTP-статусам. Главное — не хранить весь файл одной строкой и отличать неверные записи от ошибок чтения.
Применим владение, заимствование и Result из предыдущего введения в Rust к файловому вводу-выводу. Пример выполнен с Rust 1.100.0, edition 2024, на macOS arm64 и использует только стандартную библиотеку. Внешние пакеты и сеть не нужны. Если инструментов разработки ещё нет, начните с официальной инструкции по установке Rust.
Для каких задач подходит Rust?
Средства преобразования, проверки и агрегации файлов, запускаемые многократно, подходят для изучения управления ресурсами и обработки ошибок Rust. При распространении бинарных файлов в команде учитывайте целевую ОС, процессор и необходимые системные библиотеки. Исполняемый файл, собранный на одной машине, не работает во всех средах.
Разовый анализ иногда быстрее выполнить в знакомом shell или Python. При выборе Rust вместо предположений о пропускной способности оцените необходимость постоянно поддерживать инструмент и затраты команды на обучение. Здесь проверяются ход обработки и поведение при ошибках; скорость и потребление памяти с другими языками не сравниваются.
Определяем формат журнала и политику ошибок
Пример читает упрощённый журнал доступа из двух полей status-code path. Это не парсер стандартного формата Nginx или Apache. Предполагается обычный файл, запись которого завершена; ротация, чтение в реальном времени и распаковка не рассматриваются.
| Условие | Обработка |
|---|---|
Два разделённых пробелами поля, трёхзначный ASCII-статус 100–599 и путь, начинающийся с / |
Увеличить valid и счётчик статуса |
| Пустая строка либо неверное число полей, статус или путь | Увеличить invalid и перейти к следующей строке |
| Ошибка открытия или чтения, неверный UTF-8 либо строка длиннее 4096 байт | Завершить анализ с кодом 2 без вывода итогов |
Достигнут EOF и invalid равен 0 |
Вывести итоги и завершиться с кодом 0 |
Достигнут EOF и invalid не меньше 1 |
Вывести итоги и завершиться с кодом 1 |
Разделители включают последовательные пробелы и табуляции. Ограничение длины включает байты окончания строки, например LF или CRLF; последняя строка может не иметь перевода строки. Пустой файл — успешный результат valid=0 invalid=0. Путь используется только для проверки формата и в итогах не сохраняется.
Ошибка вывода также даёт код 2. До завершения анализа итоги не печатаются, однако если устройство выдаст ошибку во время записи, часть результата уже может остаться записанной. Контракт требует проверять код завершения перед использованием результата.
Готовим проект
Команды и примеры рассчитаны на shell macOS или Linux. На macOS также установите Command Line Tools для нативной компоновки.
rustup toolchain install 1.100.0 --profile minimal --component rustfmt --component clippy
cargo +1.100.0 new access-summary --bin --edition 2024
cd access-summary
mkdir -p examples tests
Сохраните файлы ниже. Cargo подключает src/lib.rs как библиотеку, а src/main.rs как исполняемую программу. Это позволяет проверять открытие файла и вывод отдельно от логики агрегации.
Cargo.toml
[package]
name = "access-summary"
version = "0.1.0"
edition = "2024"

[dependencies]
rust-toolchain.toml
[toolchain]
channel = "1.100.0"
profile = "minimal"
components = ["rustfmt", "clippy"]
examples/access.log
200 /api/orders
503 /api/orders
200 /health
404 /missing
broken-line
700 /outside-range
Агрегация с BufReader и BTreeMap
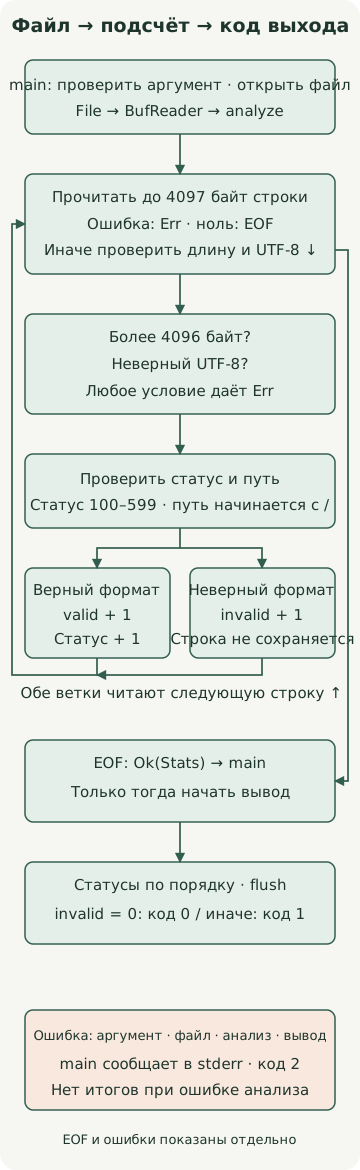
Путь цикла показывает чтение следующей строки после обработки текущей. Правая линия соединяет EOF с возвратом итогов. Ошибки аргумента, файла, анализа и вывода сведены в нижний блок; код передаёт их в main через ?.
src/lib.rs
use std::{
    collections::BTreeMap,
    io::{self, BufRead, Read},
    str,
};

pub const MAX_LINE_BYTES: usize = 4096;

#[derive(Default, Debug, PartialEq, Eq)]
pub struct Stats {
    pub valid: u64,
    pub invalid: u64,
    pub by_status: BTreeMap<u16, u64>,
}

fn parse_status(line: &str) -> Option<u16> {
    let mut fields = line.split_whitespace();
    let code = fields.next()?;
    let path = fields.next()?;
    if fields.next().is_some() || !path.starts_with('/') {
        return None;
    }
    if code.len() != 3 || !code.bytes().all(|byte| byte.is_ascii_digit()) {
        return None;
    }
    let status = code.parse::<u16>().ok()?;
    (100..=599).contains(&status).then_some(status)
}

pub fn analyze<R: BufRead>(mut reader: R) -> io::Result<Stats> {
    let mut stats = Stats::default();
    let mut buffer = Vec::new();
    loop {
        buffer.clear();
        let read = reader
            .by_ref()
            .take((MAX_LINE_BYTES + 1) as u64)
            .read_until(b'\n', &mut buffer)?;
        if read == 0 {
            return Ok(stats);
        }
        if buffer.len() > MAX_LINE_BYTES {
            return Err(io::Error::new(
                io::ErrorKind::InvalidData,
                "line exceeds 4096 bytes",
            ));
        }
        let line = str::from_utf8(&buffer)
            .map_err(|_| io::Error::new(io::ErrorKind::InvalidData, "input is not UTF-8"))?;
        match parse_status(line) {
            Some(status) => {
                stats.valid += 1;
                *stats.by_status.entry(status).or_default() += 1;
            }
            None => stats.invalid += 1,
        }
    }
}
BufReader буферизует небольшие запросы на чтение. analyze<R: BufRead> требует поведение буферизованного чтения вместо конкретного типа файла, поэтому тесты могут подставить Cursor в памяти или источник ошибки. Этот обобщённый тип не означает асинхронную или параллельную обработку.
Построчное чтение само по себе не ограничивает размер. read_until добавляет данные в буфер до разделителя или EOF и может прочитать очень длинную строку. Поэтому пример использует Read::take, чтобы за одну итерацию потребить не более 4097 байт, а затем проверить превышение 4096 байт. take ограничивает байты, но не время чтения.
buffer.clear() сбрасывает длину буфера для следующей строки и повторно использует выделенную память. Вектор агрегации содержит текущую строку, а BufReader может заранее прочитать следующие байты. Буфер чтения, выделенная память вектора и карта агрегации требуют памяти каждый. Поскольку число возможных статусов ограничено 500, рост числа URL не увеличивает число ключей карты. Это не измерение фактической памяти процесса.
parse_status заимствует строку как &str, проверяет её и возвращает только статус. BTreeMap позволяет обходить ключи по порядку, поэтому подходит для вывода статусов по возрастанию. entry(...).or_default() создаёт отсутствующий счётчик с нуля.
Вывод и коды завершения в main
src/main.rs
use access_summary::analyze;
use std::{
    env,
    fs::File,
    io::{self, BufReader, Write},
    process::ExitCode,
};

fn run() -> io::Result<u8> {
    let mut args = env::args_os().skip(1);
    let path = args
        .next()
        .filter(|_| args.next().is_none())
        .ok_or_else(|| {
            io::Error::new(io::ErrorKind::InvalidInput, "usage: access-summary <file>")
        })?;
    let stats = analyze(BufReader::new(File::open(path)?))?;
    let mut out = io::BufWriter::new(io::stdout().lock());
    writeln!(out, "valid={} invalid={}", stats.valid, stats.invalid)?;
    for (status, count) in &stats.by_status {
        writeln!(out, "status={status} count={count}")?;
    }
    out.flush()?;
    Ok(if stats.invalid == 0 { 0 } else { 1 })
}

fn main() -> ExitCode {
    match run() {
        Ok(code) => ExitCode::from(code),
        Err(error) => {
            let _ = writeln!(io::stderr().lock(), "error: {error}");
            ExitCode::from(2)
        }
    }
}
args_os получает путь к файлу как строку ОС. io::Result<Stats> анализатора соединён с io::Result<u8> функции run, поэтому ошибки открытия и анализа попадают в ветку ошибок main. BufWriter также буферизует вывод, а flush()? проверяет ошибку записи оставшихся данных. Если не удалось даже записать диагностику в стандартный поток ошибок, эта ошибка записи игнорируется и сохраняется код 2.
invalid считает записи, которые удалось прочитать, но которые не соответствуют правилам. Поэтому наличие вывода не означает, что весь ввод корректен. Код 1 означает, что анализ завершён и хотя бы одна запись неверна; если неверны все строки, valid может быть равен 0. Код 2 означает ошибку выполнения. Эти различия проверяются тестами и отдельными запусками CLI.
Запуск примера и проверка результата
cargo check --offline
cargo fmt --check
cargo clippy --offline --all-targets -- -D warnings
cargo build --offline --release
./target/release/access-summary examples/access.log
echo $?
В примере четыре корректные и две некорректные строки. Далее приведён фактический вывод. Последняя 1 — это код завершения, полученный через echo $?, а не часть итогов.
valid=4 invalid=2
status=200 count=2
status=404 count=1
status=503 count=1
1| Дополнительный ввод или условие | Стандартный вывод | Код завершения |
|---|---|---|
| Файл только с корректными строками | Полные итоги | 0 |
| Пустой файл | valid=0 invalid=0 |
0 |
| Одна пустая строка | valid=0 invalid=1 |
1 |
| Нет аргумента файла, два аргумента или файл не существует | Нет; причина в stderr | 2 |
| Неверный UTF-8 после корректной строки | Нет; причина в stderr | 2 |
| Строка длиной 4097 байт | Нет; причина в stderr | 2 |
Тестируем границы и ошибки без файлов
Cursor позволяет читать байты в памяти как входные данные. Отдельный тип также позволяет без диска и сети внедрить ошибку чтения, которую трудно воспроизвести реальным файлом. Сохраните файл ниже и выполните команду.
cargo test --offlinetests/stream.rs
use access_summary::{MAX_LINE_BYTES, analyze};
use std::io::{self, BufRead, Cursor, Read};

#[test]
fn counts_valid_and_invalid_lines_in_status_order() {
    let stats = analyze(Cursor::new(include_bytes!("../examples/access.log"))).unwrap();
    assert_eq!((stats.valid, stats.invalid), (4, 2));
    assert_eq!(
        stats.by_status.into_iter().collect::<Vec<_>>(),
        vec![(200, 2), (404, 1), (503, 1)]
    );
}

#[test]
fn accepts_crlf_and_a_final_line_without_newline() {
    let stats = analyze(Cursor::new(b"200 /a\r\n503 /b")).unwrap();
    assert_eq!((stats.valid, stats.invalid), (2, 0));
}

#[test]
fn empty_file_and_blank_line_are_different() {
    assert_eq!(analyze(Cursor::new(b"")).unwrap().invalid, 0);
    assert_eq!(analyze(Cursor::new(b"\n")).unwrap().invalid, 1);
}

#[test]
fn rejects_malformed_status_and_fields_as_invalid_records() {
    let data = "099 /a\n600 /a\n+20 /a\n200 /a\n200 relative\n200 /a extra\n200\n";
    let stats = analyze(Cursor::new(data.as_bytes())).unwrap();
    assert_eq!((stats.valid, stats.invalid), (0, 7));
}

#[test]
fn invalid_utf8_aborts_instead_of_reporting_partial_statistics() {
    let error = analyze(Cursor::new(b"200 /a\n\xff\n")).unwrap_err();
    assert_eq!(error.kind(), io::ErrorKind::InvalidData);
    assert_eq!(error.to_string(), "input is not UTF-8");
}

#[test]
fn accepts_exact_byte_limit_including_newline() {
    let mut data = b"200 /".to_vec();
    data.resize(MAX_LINE_BYTES - 1, b'a');
    data.push(b'\n');
    assert_eq!(analyze(Cursor::new(data)).unwrap().valid, 1);
}

#[test]
fn stops_consuming_an_oversized_line_after_limit_plus_one() {
    let mut reader = Cursor::new(vec![b'x'; 100_000]);
    let error = analyze(&mut reader).unwrap_err();
    assert_eq!(error.to_string(), "line exceeds 4096 bytes");
    assert_eq!(reader.position(), (MAX_LINE_BYTES + 1) as u64);
}

struct FailingReader;
impl Read for FailingReader {
    fn read(&mut self, _: &mut [u8]) -> io::Result<usize> {
        Err(io::Error::other("injected read failure"))
    }
}
impl BufRead for FailingReader {
    fn fill_buf(&mut self) -> io::Result<&[u8]> {
        Err(io::Error::other("injected read failure"))
    }
    fn consume(&mut self, _: usize) {}
}

#[test]
fn propagates_reader_failure() {
    assert_eq!(
        analyze(FailingReader).unwrap_err().to_string(),
        "injected read failure"
    );
}
Все восемь выполненных тестов прошли. Отдельные CLI-проверки сравнили вывод и коды завершения в режимах debug и release и подтвердили подсчёт 100 000 одинаковых корректных строк. Эти данные проверяли точность агрегации; это не нагрузочный тест, гарантирующий пропускную способность, максимальный размер файла или расход памяти.
Для развития в эксплуатационный инструмент сначала выберите парсер реального формата и начните с файлов, запись которых завершена. Для агрегации по URL или сбора в реальном времени отдельно проектируйте число ключей, срок хранения, ротацию файлов и правила дублирования при перезапуске. Простое расширение подсчёта статусов из этого примера не решает эти задачи.
Обсуждение