Rust en la práctica: una CLI para contar estados HTTP en registros
En esta página
Una CLI de procesamiento de archivos con entradas y resultados claros es una buena forma de empezar a usar Rust en tareas reales. Este artículo lee un registro línea a línea y cuenta las solicitudes por código de estado HTTP. La clave es no guardar el archivo completo como una cadena y distinguir los registros inválidos de los errores de lectura.
Aplicamos propiedad, préstamos y Result de la introducción anterior a Rust a la E/S de archivos. El ejemplo se ejecutó con Rust 1.100.0, edición 2024, en macOS arm64 y solo usa la biblioteca estándar. No requiere paquetes externos ni conexión de red. Si aún no tienes las herramientas, sigue la guía oficial de instalación de Rust.
¿Para qué tareas resulta útil Rust?
Las herramientas de conversión, validación y agregación de archivos que se ejecutan repetidamente son buenas candidatas para aprender la gestión de recursos y errores de Rust. Al distribuir binarios a un equipo, deben coincidir el sistema operativo, la CPU y las bibliotecas de sistema necesarias. Un ejecutable compilado en una máquina no funcionará en todos los entornos.
Un análisis puntual puede terminarse más rápido con un shell conocido o con Python. En lugar de suponer una mayor capacidad de procesamiento, valora la necesidad de mantener la herramienta a lo largo del tiempo y el coste de aprendizaje del equipo. Aquí verificamos el flujo y los fallos; no comparamos la velocidad ni el uso de memoria con otros lenguajes.
Definir el formato del registro y la política de fallos
El ejemplo lee un registro de acceso simplificado con dos campos, status-code path. No analiza directamente el formato predeterminado de Nginx o Apache. Se supone que la entrada es un archivo normal cuya escritura ya terminó; no se tratan la rotación, el seguimiento en tiempo real ni la descompresión.
| Condición | Tratamiento |
|---|---|
Dos campos separados por espacios, estado ASCII de tres dígitos entre 100–599 y ruta que empieza por / |
Incrementar valid y el contador del estado |
| Línea vacía o número de campos, estado o ruta que incumple las reglas | Incrementar invalid y procesar la línea siguiente |
| Error al abrir o leer el archivo, UTF-8 inválido o línea de más de 4096 bytes | Fallar el análisis y salir con código 2 sin imprimir el resumen |
Llegar a EOF con invalid igual a 0 |
Imprimir el resumen y salir con código 0 |
Llegar a EOF con invalid igual o mayor que 1 |
Imprimir el resumen y salir con código 1 |
La separación por espacios también incluye espacios consecutivos y tabulaciones. El límite de longitud incluye bytes de fin de línea como LF o CRLF; la última línea puede carecer de salto. Un archivo vacío produce un resultado correcto valid=0 invalid=0. La ruta solo se usa para comprobar el formato y no se almacena en el resumen.
Un fallo de salida también produce el código 2. El resumen no se imprime antes de terminar el análisis, pero si el dispositivo falla durante la escritura pueden quedar resultados ya escritos. El contrato de ejecución exige comprobar el código de salida antes de utilizar el resultado.
Preparar el proyecto
Estos comandos y ejemplos usan un shell de macOS o Linux. En macOS instala también las Command Line Tools necesarias para el enlace nativo.
rustup toolchain install 1.100.0 --profile minimal --component rustfmt --component clippy
cargo +1.100.0 new access-summary --bin --edition 2024
cd access-summary
mkdir -p examples tests
Guarda los archivos siguientes. Cargo conecta src/lib.rs como biblioteca y src/main.rs como ejecutable. Esta separación permite comprobar la apertura del archivo y la salida en pantalla por separado de la lógica de agregación.
Cargo.toml
[package]
name = "access-summary"
version = "0.1.0"
edition = "2024"

[dependencies]
rust-toolchain.toml
[toolchain]
channel = "1.100.0"
profile = "minimal"
components = ["rustfmt", "clippy"]
examples/access.log
200 /api/orders
503 /api/orders
200 /health
404 /missing
broken-line
700 /outside-range
Agregar con BufReader y BTreeMap
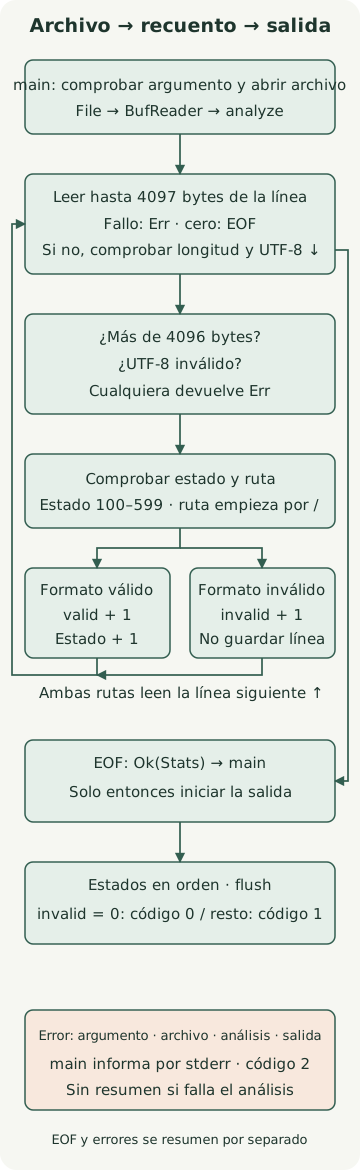
La ruta del bucle representa la lectura de la siguiente línea después de procesar una. La línea de la derecha conecta EOF con la devolución de los totales. Los errores de argumento, archivo, análisis y salida se resumen en el cuadro inferior; el código los propaga a main mediante ?.
src/lib.rs
use std::{
    collections::BTreeMap,
    io::{self, BufRead, Read},
    str,
};

pub const MAX_LINE_BYTES: usize = 4096;

#[derive(Default, Debug, PartialEq, Eq)]
pub struct Stats {
    pub valid: u64,
    pub invalid: u64,
    pub by_status: BTreeMap<u16, u64>,
}

fn parse_status(line: &str) -> Option<u16> {
    let mut fields = line.split_whitespace();
    let code = fields.next()?;
    let path = fields.next()?;
    if fields.next().is_some() || !path.starts_with('/') {
        return None;
    }
    if code.len() != 3 || !code.bytes().all(|byte| byte.is_ascii_digit()) {
        return None;
    }
    let status = code.parse::<u16>().ok()?;
    (100..=599).contains(&status).then_some(status)
}

pub fn analyze<R: BufRead>(mut reader: R) -> io::Result<Stats> {
    let mut stats = Stats::default();
    let mut buffer = Vec::new();
    loop {
        buffer.clear();
        let read = reader
            .by_ref()
            .take((MAX_LINE_BYTES + 1) as u64)
            .read_until(b'\n', &mut buffer)?;
        if read == 0 {
            return Ok(stats);
        }
        if buffer.len() > MAX_LINE_BYTES {
            return Err(io::Error::new(
                io::ErrorKind::InvalidData,
                "line exceeds 4096 bytes",
            ));
        }
        let line = str::from_utf8(&buffer)
            .map_err(|_| io::Error::new(io::ErrorKind::InvalidData, "input is not UTF-8"))?;
        match parse_status(line) {
            Some(status) => {
                stats.valid += 1;
                *stats.by_status.entry(status).or_default() += 1;
            }
            None => stats.invalid += 1,
        }
    }
}
BufReader almacena en búfer pequeñas solicitudes de lectura. analyze<R: BufRead> exige lectura con búfer en lugar de un tipo concreto de archivo, por lo que las pruebas pueden sustituirlo por un Cursor en memoria o una entrada que falle. Este genérico no implica procesamiento asíncrono ni paralelo.
Leer línea a línea no establece por sí solo un límite de tamaño. read_until añade datos a un búfer hasta el delimitador o EOF y puede leer líneas muy largas. Por ello, el ejemplo usa Read::take para consumir como máximo 4097 bytes en cada iteración antes de comprobar si la línea supera 4096 bytes. take limita bytes, no el tiempo de lectura.
buffer.clear() pone a cero la longitud del búfer para la siguiente línea y reutiliza la memoria asignada. El vector de agregación contiene la línea actual y BufReader puede haber leído bytes posteriores por anticipado. El búfer de lectura, la asignación del vector y el mapa necesitan memoria por separado. Como los códigos de estado se limitan a 500 tipos como máximo, un mayor número de URL no aumenta las claves del mapa. Esto no es una medición de la memoria real del proceso.
parse_status toma prestada la cadena como &str, la comprueba y devuelve solo el código de estado. BTreeMap permite iterar en orden de clave, lo que sirve para imprimir los estados en orden ascendente. entry(...).or_default() inicia en cero un contador que no exista.
Decidir la salida y el código de salida en main
src/main.rs
use access_summary::analyze;
use std::{
    env,
    fs::File,
    io::{self, BufReader, Write},
    process::ExitCode,
};

fn run() -> io::Result<u8> {
    let mut args = env::args_os().skip(1);
    let path = args
        .next()
        .filter(|_| args.next().is_none())
        .ok_or_else(|| {
            io::Error::new(io::ErrorKind::InvalidInput, "usage: access-summary <file>")
        })?;
    let stats = analyze(BufReader::new(File::open(path)?))?;
    let mut out = io::BufWriter::new(io::stdout().lock());
    writeln!(out, "valid={} invalid={}", stats.valid, stats.invalid)?;
    for (status, count) in &stats.by_status {
        writeln!(out, "status={status} count={count}")?;
    }
    out.flush()?;
    Ok(if stats.invalid == 0 { 0 } else { 1 })
}

fn main() -> ExitCode {
    match run() {
        Ok(code) => ExitCode::from(code),
        Err(error) => {
            let _ = writeln!(io::stderr().lock(), "error: {error}");
            ExitCode::from(2)
        }
    }
}
args_os recibe la ruta como cadena del sistema operativo. El io::Result<Stats> del analizador se conecta al io::Result<u8> de run, por lo que los fallos al abrir o analizar llegan a la rama de error de main. BufWriter también almacena la salida en búfer y flush()? detecta si falla la escritura pendiente. Si incluso falla la escritura del diagnóstico en el error estándar, se ignora ese fallo y se conserva el código 2.
invalid cuenta los registros legibles que incumplen las reglas. La existencia de salida no significa que todas las entradas fueran válidas. El código 1 indica que el análisis terminó con al menos un registro inválido; si todas las líneas eran inválidas, valid puede ser 0. El código 2 indica un fallo de ejecución. Las pruebas y ejecuciones independientes de la CLI comprueban esta distinción.
Ejecutar el ejemplo y comprobar el resultado
cargo check --offline
cargo fmt --check
cargo clippy --offline --all-targets -- -D warnings
cargo build --offline --release
./target/release/access-summary examples/access.log
echo $?
El ejemplo tiene cuatro líneas válidas y dos inválidas. A continuación aparece la salida real. El 1 final es el código de salida observado con echo $?, no parte del resumen.
valid=4 invalid=2
status=200 count=2
status=404 count=1
status=503 count=1
1| Entrada adicional o condición | Salida estándar | Código de salida |
|---|---|---|
| Archivo con solo líneas válidas | Resumen completo | 0 |
| Archivo vacío | valid=0 invalid=0 |
0 |
| Una línea vacía | valid=0 invalid=1 |
1 |
| Falta el argumento del archivo, hay dos argumentos o el archivo no existe | Ninguna; causa en error estándar | 2 |
| UTF-8 inválido después de una línea válida | Ninguna; causa en error estándar | 2 |
| Una línea de 4097 bytes | Ninguna; causa en error estándar | 2 |
Probar límites y fallos sin archivos
Cursor permite leer bytes en memoria como entrada. Sin depender del disco ni de la red, un tipo separado también inyecta un fallo de lectura que sería difícil de reproducir con un archivo real. Guarda el siguiente archivo y ejecuta el comando.
cargo test --offlinetests/stream.rs
use access_summary::{MAX_LINE_BYTES, analyze};
use std::io::{self, BufRead, Cursor, Read};

#[test]
fn counts_valid_and_invalid_lines_in_status_order() {
    let stats = analyze(Cursor::new(include_bytes!("../examples/access.log"))).unwrap();
    assert_eq!((stats.valid, stats.invalid), (4, 2));
    assert_eq!(
        stats.by_status.into_iter().collect::<Vec<_>>(),
        vec![(200, 2), (404, 1), (503, 1)]
    );
}

#[test]
fn accepts_crlf_and_a_final_line_without_newline() {
    let stats = analyze(Cursor::new(b"200 /a\r\n503 /b")).unwrap();
    assert_eq!((stats.valid, stats.invalid), (2, 0));
}

#[test]
fn empty_file_and_blank_line_are_different() {
    assert_eq!(analyze(Cursor::new(b"")).unwrap().invalid, 0);
    assert_eq!(analyze(Cursor::new(b"\n")).unwrap().invalid, 1);
}

#[test]
fn rejects_malformed_status_and_fields_as_invalid_records() {
    let data = "099 /a\n600 /a\n+20 /a\n200 /a\n200 relative\n200 /a extra\n200\n";
    let stats = analyze(Cursor::new(data.as_bytes())).unwrap();
    assert_eq!((stats.valid, stats.invalid), (0, 7));
}

#[test]
fn invalid_utf8_aborts_instead_of_reporting_partial_statistics() {
    let error = analyze(Cursor::new(b"200 /a\n\xff\n")).unwrap_err();
    assert_eq!(error.kind(), io::ErrorKind::InvalidData);
    assert_eq!(error.to_string(), "input is not UTF-8");
}

#[test]
fn accepts_exact_byte_limit_including_newline() {
    let mut data = b"200 /".to_vec();
    data.resize(MAX_LINE_BYTES - 1, b'a');
    data.push(b'\n');
    assert_eq!(analyze(Cursor::new(data)).unwrap().valid, 1);
}

#[test]
fn stops_consuming_an_oversized_line_after_limit_plus_one() {
    let mut reader = Cursor::new(vec![b'x'; 100_000]);
    let error = analyze(&mut reader).unwrap_err();
    assert_eq!(error.to_string(), "line exceeds 4096 bytes");
    assert_eq!(reader.position(), (MAX_LINE_BYTES + 1) as u64);
}

struct FailingReader;
impl Read for FailingReader {
    fn read(&mut self, _: &mut [u8]) -> io::Result<usize> {
        Err(io::Error::other("injected read failure"))
    }
}
impl BufRead for FailingReader {
    fn fill_buf(&mut self) -> io::Result<&[u8]> {
        Err(io::Error::other("injected read failure"))
    }
    fn consume(&mut self, _: usize) {}
}

#[test]
fn propagates_reader_failure() {
    assert_eq!(
        analyze(FailingReader).unwrap_err().to_string(),
        "injected read failure"
    );
}
Las ocho pruebas ejecutadas pasaron. En comprobaciones CLI separadas se compararon la salida y los códigos de salida en debug y release y se verificó el recuento de 100 000 líneas válidas idénticas. Esa entrada comprobó la exactitud de la agregación; no fue una prueba de carga que garantice capacidad, tamaño máximo de archivo ni uso de memoria.
Para ampliar esto como herramienta operativa, elige primero un analizador adecuado al formato real y empieza con archivos cuya escritura haya terminado. La agregación por URL o la recopilación en tiempo real requieren diseñar por separado la cantidad de claves, retención, rotación y recuentos duplicados tras reinicios. Ampliar sin más el recuento por estado de este ejemplo no resuelve esos problemas.
Comentarios