Eventos Kafka: particiones, grupos, offsets y reprocesamiento
En esta página
El streaming Kafka guarda hechos en un log y permite a varios consumidores leerlos desde sus propias posiciones. Preparación de envíos y analítica pueden leer pedidos independientemente y reprocesar registros con lógica nueva. Guardar en Kafka y cambiar una DB o pago externo exactamente una vez son cuestiones distintas.
Para desarrolladores con experiencia en API HTTP y bases de datos. Relaciona topics, particiones y grupos y ejecuta publicación, consumo independiente y reproducción local. Se centra en posiciones y significado del reprocesamiento tras fallar, no en agregaciones, ventanas o joins Kafka Streams.
¿En qué difiere de una cola de trabajo?
Un evento es un hecho ocurrido, como «pedido creado». Distinguirlo de una orden, como «iniciar envío», permite usar el mismo registro en varios negocios. Kafka también reparte trabajo dentro de un grupo como cola, pero consumir no borra inmediatamente. Otros grupos y reproducciones lo leen dentro de la retención. Introducción Apache Kafka
| Concepto | Función | Decisiones de diseño |
|---|---|---|
| Productor | Escribe eventos en Kafka | Claves, ID de evento, esquemas, fallos de publicación |
| Topic | Flujo lógico de eventos relacionados | Significado, retención y compactación, permisos |
| Partición | División de un log ordenado | Ámbito de orden, distribución de claves, capacidad paralela |
| Grupo consumidor | Consumidores de la misma tarea | ID, momento de proceso y commit, reprocesamiento |
| Offset | Posición dentro de una partición | Hasta dónde se leyó y dónde continuar |
Si shipping-v1 y analytics-v1 leen orders.v1, ambos negocios reciben eventos independientemente. Si envío y analítica comparten grupo, se reparten registros y cada tarea no recibe todos.
En suscripción normal se asigna una partición a un consumidor del grupo. Cinco consumidores con 3 particiones no reciben todos una. Otros grupos asignan independientemente. Se usan suscripciones normales KafkaConsumer, distintas del consumo compartido por registro. Suscripciones KafkaConsumer
Empezar por la clave si importa el orden
Kafka define orden dentro de una partición. Si importa el orden de cambios de un pedido, empieza usando su ID como clave para la misma partición. La clave enruta, el ID de evento identifica duplicados. Si varios eventos comparten ID, podrían descartarse también eventos posteriores legítimos.
Enrutar la misma clave exige serialización, particionador y número coherentes. Aumentar particiones puede cambiar la ubicación posterior: revisa orden con lo anterior. Paralelismo ilimitado después de leer también cambia finalización. El orden Kafka no siempre coincide con el temporal de negocio. Eventos tardíos de varios emisores requieren versiones, tiempos y reglas fuera de orden.
Una clave caliente, como un cliente con casi todos los eventos, concentra carga. En vez de dividir arbitrariamente la unidad ordenada, evalúa ámbito necesario y coste de proceso.
Ejecución local: dos grupos y reproducción
Usa herramientas de la imagen Apache apache/kafka:4.1.2. Requiere Bash y Docker activo; al principio descarga la imagen. Broker y CLI comparten contenedor, sin puertos host. Los datos se eliminan al detener. La demostración usa 1 broker, 1 partición y factor 1. Instrucciones Docker
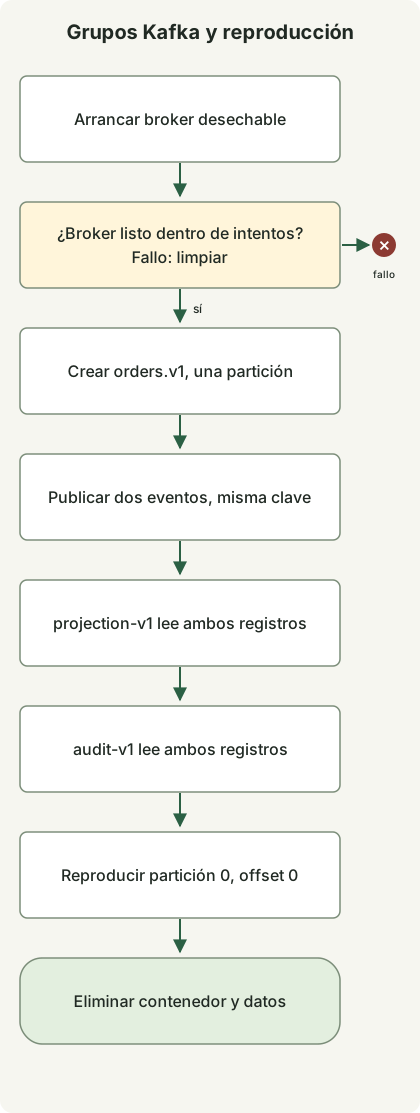
Muestra el orden correcto. Se detiene ante fallo de preparación o comando y limpia al salir si creó el contenedor. Dos lecturas de grupos y una reproducción son secuenciales. No implementa DB externa ni commits manuales.
Guarda como kafka-demo.sh y ejecuta bash kafka-demo.sh.
#!/usr/bin/env bash
set -euo pipefail

kafka_image=apache/kafka:4.1.2
kafka_name="kafka-stream-demo-$$-$RANDOM"
docker run -d --name "$kafka_name" "$kafka_image" >/dev/null
trap 'docker rm -f "$kafka_name" >/dev/null 2>&1 || true' EXIT

ready=false
for ((attempt=0; attempt<30; attempt++)); do
  if docker exec "$kafka_name" /opt/kafka/bin/kafka-topics.sh \
      --bootstrap-server localhost:9092 --list >/dev/null 2>&1; then
    ready=true
    break
  fi
  sleep 1
done
if [ "$ready" != true ]; then
  docker logs "$kafka_name" >&2
  exit 1
fi

docker exec "$kafka_name" /opt/kafka/bin/kafka-topics.sh \
  --bootstrap-server localhost:9092 --create --topic orders.v1 \
  --partitions 1 --replication-factor 1 >/dev/null

docker exec -i "$kafka_name" /opt/kafka/bin/kafka-console-producer.sh \
  --bootstrap-server localhost:9092 --topic orders.v1 \
  --producer-property acks=all --producer-property enable.idempotence=true \
  --property parse.key=true --property key.separator=: <<'EVENTS'
order-101:{"eventId":"evt-1","type":"OrderCreated","schemaVersion":1}
order-101:{"eventId":"evt-2","type":"PaymentConfirmed","schemaVersion":1}
EVENTS

for group in projection-v1 audit-v1; do
  printf 'group=%s\n' "$group"
  docker exec "$kafka_name" /opt/kafka/bin/kafka-console-consumer.sh \
    --bootstrap-server localhost:9092 --topic orders.v1 --group "$group" \
    --from-beginning --max-messages 2 --timeout-ms 15000 \
    --property print.key=true --property 'key.separator=|'
done

printf 'replay=partition-0-offset-0\n'
docker exec "$kafka_name" /opt/kafka/bin/kafka-console-consumer.sh \
  --bootstrap-server localhost:9092 --topic orders.v1 \
  --partition 0 --offset 0 --max-messages 2 --timeout-ms 15000 \
  --property print.key=true --property 'key.separator=|'
Esta salida estándar se verificó con Docker Engine 24.0.5 y apache/kafka:4.1.2. Cada consumo escribe además Processed a total of 2 messages por error estándar.
group=projection-v1
order-101|{"eventId":"evt-1","type":"OrderCreated","schemaVersion":1}
order-101|{"eventId":"evt-2","type":"PaymentConfirmed","schemaVersion":1}
group=audit-v1
order-101|{"eventId":"evt-1","type":"OrderCreated","schemaVersion":1}
order-101|{"eventId":"evt-2","type":"PaymentConfirmed","schemaVersion":1}
replay=partition-0-offset-0
order-101|{"eventId":"evt-1","type":"OrderCreated","schemaVersion":1}
order-101|{"eventId":"evt-2","type":"PaymentConfirmed","schemaVersion":1}
Cada grupo leyó ambos eventos y la reproducción los mismos dos registros. Confirma que un grupo no impide leer a otro ni reproducir. Con una partición no verifica orden entre particiones ni asignación paralela.
Comprueba consumo de consola con auto-commit predeterminado. No implementa commit manual tras negocio ni fallos entre proceso y commit. Tampoco validación JSON, DB o pagos externos ni proceso durante rebalanceos.
¿Garantiza el commit completar el negocio?
No. La posición avanza con poll(), pero la posición confirmada para reiniciar es distinta. Tras completar offset 10 se confirma normalmente 11, el siguiente. Gestiona rangos por partición. Por borrado, transacciones y otros factores los offsets no implican necesariamente registros enteros consecutivos. Posiciones y commits
| Orden y punto de fallo | Resultado posible al reiniciar | Tratamiento |
|---|---|---|
| Commit → terminar antes de cambiar DB | Cambio omitido, falta actualización | Ordenar commit según semántica requerida |
| Cambiar DB → terminar antes de commit | Nueva entrega y proceso | Idempotencia o deduplicación |
| Confirmar posición posterior tras fallos | Pueden saltarse registros fallidos | Confirmar solo rango consecutivo correcto |
| Reasignar partición | Trabajo anterior y nuevo pueden solaparse | Detener propietario anterior y evitar efectos duplicados |
Un consumidor puede comprobar unicidad (처리기 ID, eventId) y aplicar el cambio en la misma transacción DB. Guardar primero solo la marca y fallar después puede confundir la siguiente entrega con duplicado. Guardarla aparte después permite duplicación si falla entre ambos. Otras API no entran automáticamente: necesitan claves idempotentes y comprobar resultados.
enable.idempotence trata duplicados del log por reintentos del productor, no toda doble publicación nueva de la aplicación. acks=all tampoco garantiza cero pérdidas bajo cualquier ajuste. Revisa replicación, min.insync.replicas e ISR real juntos. Un broker no verifica tolerancia a perderlo. Configuración del productor
Distingue transacciones Kafka que unen offsets y salidas consumidas con read_committed de aplicar efectos externos exactamente una vez. Sin cooperación externa Kafka no vuelve todo exactly-once. Semántica y transacciones
Diseñar reintentos y reproducción como rutas normales
Limita reintentos temporales por cantidad, tiempo total y concurrencia. Si un evento bloquea la partición, valora aplazarlo, comprobando si avanzar otros rompe orden. Enviar a DLQ no completa negocio. Conserva ID original, causa, versión, responsable y plazo; trata fallos entre escribir DLQ y avanzar offset.
Un productor con commit DB y publicación aparte puede fallar entre ambos. Guardar cambio y outbox en una transacción y entregar después es una solución; el consumidor sigue tratando duplicados. Añadir Kafka no une DB y log en una transacción. Transactional outbox
--from-beginning no rebobina siempre un grupo con posición válida. El ejemplo usa grupos nuevos y al final especifica partición y offset. Cambiar uno existente requiere parar consumidores y verificar objetivo, alcance y efectos. Incluso un grupo nuevo repite pagos o avisos: aísla salida o usa idempotencia. Configuración de reinicio
Si el proceso supera la retención, pueden haberse borrado registros. Compactar tampoco conserva todo estado histórico. Define rango reproducible con retención, compactación y capacidad de interpretar esquemas.
Empieza con un flujo y prueba normalidad, terminación tras DB antes del commit, reinicios, rebalanceos, esquemas inválidos, dependencias lentas y efectos duplicados. lag es diferencia entre final y posición de consumo o commit: especifica cuáles. Observa también retraso hasta negocio, fallos, reintentos, DLQ, rebalanceos, almacenamiento y replicación para distinguir leer de completar.
Comentarios