Streaming d’événements Kafka : groupes, offsets et retraitement
Sur cette page
Le streaming d’événements Kafka conserve des faits dans un journal et permet à plusieurs consommateurs de les lire et traiter depuis leurs propres positions. La préparation des expéditions et l’analytique peuvent lire indépendamment les événements de commande, et les enregistrements stockés peuvent être retraités avec une nouvelle logique. Cependant, stocker un événement dans Kafka et modifier exactement une fois une base externe ou un paiement sont des questions distinctes.
Cet article s’adresse aux développeurs connaissant les API HTTP et les bases de données. Il relie topics, partitions et groupes de consommateurs, puis exécute publication, consommation indépendante et rejeu dans Kafka local. Il se concentre sur les positions des consommateurs et le sens du retraitement après échec, plutôt que sur l’implémentation d’agrégations, fenêtres ou jointures dans Kafka Streams.
En quoi le streaming d’événements diffère-t-il d’une file de travail ?
Un événement est un fait déjà survenu, comme « une commande a été créée ». Le distinguer d’une commande demandant une action précise, comme « commencer l’expédition », permet à plusieurs consommateurs d’utiliser le même enregistrement pour leurs propres tâches métier. Kafka peut aussi répartir le travail dans un groupe comme une file, mais consommer un enregistrement ne le supprime pas immédiatement. D’autres groupes et jobs de rejeu peuvent le relire selon la politique de rétention. Introduction à Apache Kafka
| Concept | Rôle | Décisions de conception |
|---|---|---|
| Producteur | Écrit des événements dans Kafka | Clés, identifiants d’événements, schémas, traitement des échecs de publication |
| Topic | Flux logique d’événements liés | Sens des événements, politiques de rétention et compactage, droits d’accès |
| Partition | Division d’un journal ordonné | Périmètre d’ordre, répartition des clés, débit parallèle |
| Groupe de consommateurs | Ensemble de consommateurs partageant la même tâche métier | Identifiant de groupe, moments de traitement et commit, politique de retraitement |
| Offset | Position d’un enregistrement dans une partition | Jusqu’où la lecture est arrivée et où reprendre |
Par exemple, si les groupes shipping-v1 et analytics-v1 lisent le topic orders.v1, les deux tâches métier peuvent recevoir les mêmes événements indépendamment. Si les consommateurs d’expédition et d’analytique sont placés dans le même groupe, ils se répartissent les enregistrements : aucune tâche n’est alors configurée pour recevoir tous les événements.
Avec les abonnements de groupe ordinaires, une partition est affectée à un consommateur au sein d’un groupe. Cinq consommateurs dans un groupe lisant 3 partitions ne reçoivent pas tous une partition. Les affectations sont indépendantes dans les autres groupes. Cet article utilise les abonnements de groupe ordinaires KafkaConsumer, distincts des modèles de consommation partagée par enregistrement. Abonnements de groupe KafkaConsumer
Commencer par la clé lorsque l’ordre compte
Kafka définit l’ordre des enregistrements dans une partition. Si la séquence des changements d’état d’une commande compte, commencez par utiliser son identifiant comme clé pour les diriger vers la même partition. Une clé détermine le routage ; un identifiant d’événement identifie les doublons. Leurs rôles diffèrent. Si plusieurs événements d’une même commande partagent le même identifiant d’événement, des événements ultérieurs légitimes peuvent aussi être éliminés comme doublons.
Le routage d’une même clé nécessite aussi une sérialisation des clés, un partitionnement et un nombre de partitions cohérents. Augmenter le nombre de partitions peut changer la destination des enregistrements suivants ; examinez leur ordre par rapport aux précédents. Une exécution parallèle illimitée après lecture d’une partition change aussi l’ordre d’achèvement. L’ordre du journal Kafka ne correspond pas toujours à l’ordre temporel métier. Traiter des événements tardifs de plusieurs émetteurs nécessite des versions métier, des dates de survenue et des règles de traitement hors ordre.
Une clé très sollicitée, comme un client représentant la majorité des événements, peut concentrer la charge sur une partition. Au lieu de découper arbitrairement une unité d’ordre en clés plus petites, examinez le périmètre d’ordre nécessaire avec le coût du traitement.
Exécution locale : deux groupes lisent les mêmes enregistrements, puis les rejouent
L’exemple suivant utilise les outils inclus dans l’image Apache apache/kafka:4.1.2. Il nécessite Bash et Docker actif ; la première exécution doit télécharger l’image. Le broker et la CLI tournent dans le même conteneur, sans port hôte exposé. Les données d’exercice sont supprimées à l’arrêt du conteneur. Cette démonstration fonctionnelle utilise 1 broker, 1 partition et un facteur de réplication de 1. Instructions Docker officielles
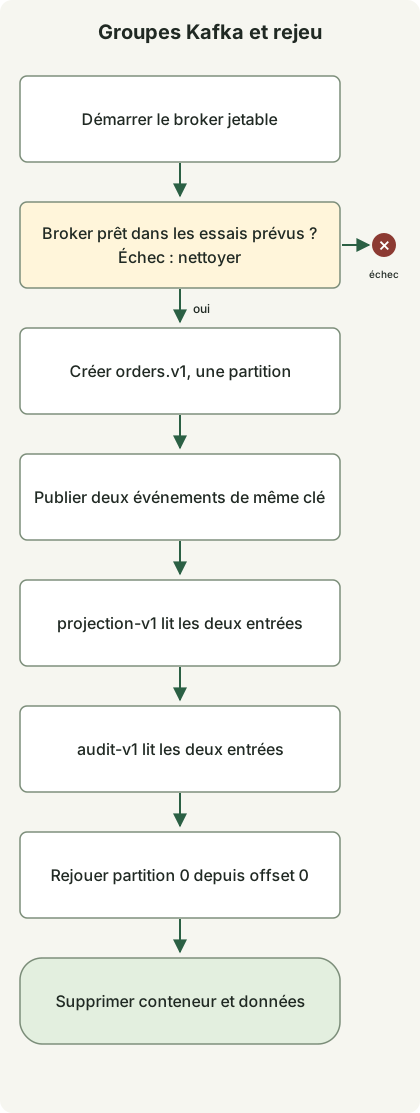
Le schéma montre l’ordre d’exécution réussi du script. Il s’arrête en cas d’échec de disponibilité ou de commande et nettoie le conteneur à la sortie si sa création a réussi. Les deux lectures de groupe et le rejeu direct s’exécutent séquentiellement. Le traitement en base externe et les commits manuels d’offset ne sont pas implémentés.
Enregistrez ceci sous kafka-demo.sh et exécutez bash kafka-demo.sh.
#!/usr/bin/env bash
set -euo pipefail

kafka_image=apache/kafka:4.1.2
kafka_name="kafka-stream-demo-$$-$RANDOM"
docker run -d --name "$kafka_name" "$kafka_image" >/dev/null
trap 'docker rm -f "$kafka_name" >/dev/null 2>&1 || true' EXIT

ready=false
for ((attempt=0; attempt<30; attempt++)); do
  if docker exec "$kafka_name" /opt/kafka/bin/kafka-topics.sh \
      --bootstrap-server localhost:9092 --list >/dev/null 2>&1; then
    ready=true
    break
  fi
  sleep 1
done
if [ "$ready" != true ]; then
  docker logs "$kafka_name" >&2
  exit 1
fi

docker exec "$kafka_name" /opt/kafka/bin/kafka-topics.sh \
  --bootstrap-server localhost:9092 --create --topic orders.v1 \
  --partitions 1 --replication-factor 1 >/dev/null

docker exec -i "$kafka_name" /opt/kafka/bin/kafka-console-producer.sh \
  --bootstrap-server localhost:9092 --topic orders.v1 \
  --producer-property acks=all --producer-property enable.idempotence=true \
  --property parse.key=true --property key.separator=: <<'EVENTS'
order-101:{"eventId":"evt-1","type":"OrderCreated","schemaVersion":1}
order-101:{"eventId":"evt-2","type":"PaymentConfirmed","schemaVersion":1}
EVENTS

for group in projection-v1 audit-v1; do
  printf 'group=%s\n' "$group"
  docker exec "$kafka_name" /opt/kafka/bin/kafka-console-consumer.sh \
    --bootstrap-server localhost:9092 --topic orders.v1 --group "$group" \
    --from-beginning --max-messages 2 --timeout-ms 15000 \
    --property print.key=true --property 'key.separator=|'
done

printf 'replay=partition-0-offset-0\n'
docker exec "$kafka_name" /opt/kafka/bin/kafka-console-consumer.sh \
  --bootstrap-server localhost:9092 --topic orders.v1 \
  --partition 0 --offset 0 --max-messages 2 --timeout-ms 15000 \
  --property print.key=true --property 'key.separator=|'
Voici la sortie standard vérifiée avec Docker Engine 24.0.5 et apache/kafka:4.1.2. Chaque commande de consommation écrit aussi séparément Processed a total of 2 messages sur la sortie d’erreur standard.
group=projection-v1
order-101|{"eventId":"evt-1","type":"OrderCreated","schemaVersion":1}
order-101|{"eventId":"evt-2","type":"PaymentConfirmed","schemaVersion":1}
group=audit-v1
order-101|{"eventId":"evt-1","type":"OrderCreated","schemaVersion":1}
order-101|{"eventId":"evt-2","type":"PaymentConfirmed","schemaVersion":1}
replay=partition-0-offset-0
order-101|{"eventId":"evt-1","type":"OrderCreated","schemaVersion":1}
order-101|{"eventId":"evt-2","type":"PaymentConfirmed","schemaVersion":1}
Chaque groupe a lu les deux événements, et le rejeu direct final a lu les deux mêmes enregistrements. Cela vérifie que la consommation par un groupe n’empêche ni la lecture d’un autre ni le rejeu du journal. Avec une seule partition, cela ne vérifie ni l’ordre entre partitions ni les affectations parallèles au sein d’un groupe.
L’exemple vérifie la consommation avec les outils console et le réglage auto-commit par défaut. Il n’implémente pas d’application committant manuellement après le traitement métier et ne teste pas les échecs entre traitement et commit. La validation du schéma JSON d’entrée, les mises à jour de base externe ou de paiement et le traitement pendant les rééquilibrages ne sont pas implémentés non plus.
Committer un offset garantit-il l’achèvement métier ?
Non. La position courante d’un consommateur peut avancer à mesure que poll() reçoit des enregistrements, mais la position committée utilisée après redémarrage est distincte. En traitement séquentiel, après avoir achevé l’offset 10, vous committez généralement 11, la prochaine position à lire. Avec plusieurs partitions, gérez les plages achevées pour chacune. Les offsets ne représentent pas nécessairement une suite continue d’enregistrements numérotés par des entiers, à cause des suppressions, transactions et autres facteurs. Positions et commits KafkaConsumer
| Ordre d’exécution et point d’échec | Résultat possible après redémarrage | Traitement nécessaire |
|---|---|---|
| Committer l’offset → terminer avant la modification en base | Mise à jour métier omise car cette modification est sautée | Adapter l’ordre du commit à la sémantique de livraison requise |
| Achever la modification en base → terminer avant le commit d’offset | Nouvelle livraison et retraitement du même événement | Traitement idempotent ou déduplication |
| Committer une position ultérieure après l’échec de certains enregistrements | Les enregistrements en échec peuvent être sautés | Ne committer que la plage contiguë traitée avec succès |
| Réaffecter une partition à un autre consommateur | Le travail existant peut chevaucher celui du nouveau propriétaire | Arrêter le travail de l’ancien propriétaire et éviter les effets externes en double |
Un consommateur mettant à jour une base externe peut, par exemple, vérifier l’unicité de (처리기 ID, eventId) et appliquer la modification métier réelle dans la même transaction de base. Enregistrer d’abord seulement le marqueur de traitement puis échouer sur la modification peut faire prendre la livraison suivante pour un doublon. Enregistrer le marqueur séparément après la modification peut au contraire produire une modification en double si un échec survient entre les deux. Les appels à d’autres API externes ne sont pas automatiquement inclus dans cette transaction ; ces API ont donc aussi besoin de clés d’idempotence et de vérification du résultat.
Le enable.idempotence du producteur traite les enregistrements de journal en double dus aux nouvelles tentatives du producteur ; il ne supprime pas tous les cas où une application publie deux fois le même événement métier comme nouvelles publications. acks=all ne garantit pas non plus l’absence de perte indépendamment des autres réglages. Examinez ensemble le facteur de réplication, min.insync.replicas et l’état ISR réel. L’exercice à un broker ci-dessus ne vérifie pas la tolérance à la perte d’un broker. Configuration du producteur
Distinguez un traitement combinant offsets d’entrée et enregistrements du topic de sortie avec les transactions Kafka et consommant avec read_committed, de l’application exactement une fois d’effets en base externe ou sur des paiements. Sans coopération des systèmes externes, Kafka ne rend pas tout exactement une fois. Sémantique de livraison et transactions Kafka
Concevoir nouvelles tentatives et rejeu comme des parcours opérationnels normaux
Pour les échecs externes temporaires, limitez les nouvelles tentatives en nombre, durée totale et concurrence. Si un événement durablement en échec bloque toute la partition, envisagez un parcours de traitement différé, mais vérifiez si faire avancer les événements suivants du flux d’origine rompt l’ordre métier. Envoyer un événement en échec dans un topic DLQ distinct ne termine pas la tâche métier. Conservez l’identifiant d’événement initial, le motif d’échec, la version du schéma, la personne responsable du retraitement et l’échéance de résolution, et traitez les échecs entre écriture DLQ et avancement de l’offset d’entrée.
Un producteur qui committe en base et publie dans Kafka séparément peut aussi échouer entre ces actions. Enregistrer la modification de base et une entrée outbox dans la même transaction, puis la livrer, est une réponse ; les consommateurs doivent toujours gérer les livraisons en double. Ajouter Kafka ne place pas la base source et le journal dans une transaction commune. Modèle transactional outbox
--from-beginning ne rembobine pas inconditionnellement un groupe possédant une position committée valide. L’exercice utilise de nouveaux groupes et l’étape finale précise directement partition et offset de départ au lieu de réinitialiser un groupe. Un rejeu opérationnel changeant la position d’un groupe existant exige une procédure distincte : arrêtez les consommateurs et vérifiez d’abord cible, plage et effets externes. Même un rejeu avec un nouveau groupe peut redéclencher paiements ou notifications ; une isolation des sorties ou une politique d’idempotence est donc nécessaire. Configuration de réinitialisation des offsets consommateur
Si le traitement prend plus de retard que la durée de rétention, les enregistrements nécessaires peuvent déjà avoir été supprimés. Le compactage du journal ne conserve pas non plus tous les états historiques d’une clé. Définissez la plage rejouable avec les politiques de rétention et de compactage et la capacité à interpréter les schémas requis.
Pour une première adoption, choisissez un flux métier et vérifiez, outre le traitement normal, la terminaison après mise à jour en base et avant commit, les redémarrages, les rééquilibrages, les schémas invalides, les dépendances externes retardées et les effets en double au rejeu. lag est l’écart entre une position finale choisie et une position consommateur ou committée ; précisez donc les positions utilisées par la métrique. Outre le lag, observez le délai entre survenue de l’événement et mise à jour métier, les échecs, nouvelles tentatives, DLQ, rééquilibrages, stockage du broker et état de réplication pour distinguer « lire les enregistrements » et « achever la tâche métier ».
Discussion